突破视频生成大模型的工程瓶颈:全链路推理加速与自动化实践
原视频:让 MiniMax H3 又快,又强 · 配套资料:让 MiniMax-H3 又快又强 课件
从显存墙到实时流,解析高分辨率长视频生成的底层架构演进
视频生成大模型已能产出令人惊艳的短片段,但要将 15 秒、768P 的原生输出变成可商用的高清长视频,工程团队面临一连串环环相扣的瓶颈:分辨率不够需要超分,超分撑爆显存需要多卡分布式,时长受限需要续写,续写推高计算量需要加速,加速后又卡在数据搬运……每解决一个问题,都会暴露下一层矛盾。
本文以 vLLM-Omni(一个用于模型推理加速的开源框架,支持多卡和跨机互联)对 MiniMax H3 视频模型的全链路优化为线索,沿真实的工程因果链——画质、显存、时长、速度、交付、易用——逐层展开,剖析每一步的技术选型、关键机制与量化效果。文中数据均来自演讲材料与 PPT 标注,特定条件已在对应位置注明。
适读人群:具备一定深度学习基础的 AI 工程开发人员、模型推理优化工程师及技术架构师。
前置知识:
- 了解 Diffusion 模型的基本去噪过程
- 熟悉 Transformer 注意力机制与多卡并行基础
- 对显存占用与端到端延迟有基本概念
阅读目标:
- 理解高分辨率视频超分在多卡环境下的显存优化策略
- 掌握长视频续写中的潜变量条件提取与时间对齐机制
- 洞悉注意力稀疏化、投影缓存等推理加速手段的因果关系
- 了解如何将底层推理能力封装为自动化工作流
商业画质的工程妥协:超分路线的抉择与代价
768P 到底差在哪里
MiniMax H3(MiniMax 推出的视频生成大模型)原生输出上限为 1344×768 像素、时长 15 秒。这一分辨率在消费端被普遍归类为"768P",而当前用户可接受的最低商用门槛是 1080P——无论短视频平台还是影视预演,768P 画面一旦全屏投放就会出现可感知的清晰度不足。如果没有可靠的超分辨率(Super-Resolution)环节,模型内部的生成加速对最终商用价值贡献有限。
核心工程矛盾由此浮现:在画质保真度与推理速度之间,超分路线该怎么选?
两条路径的流程对比
下图直接对比了两种从 768P 到 1080P 的技术路线,帮助理解它们在数据流和操作空间上的根本差异:
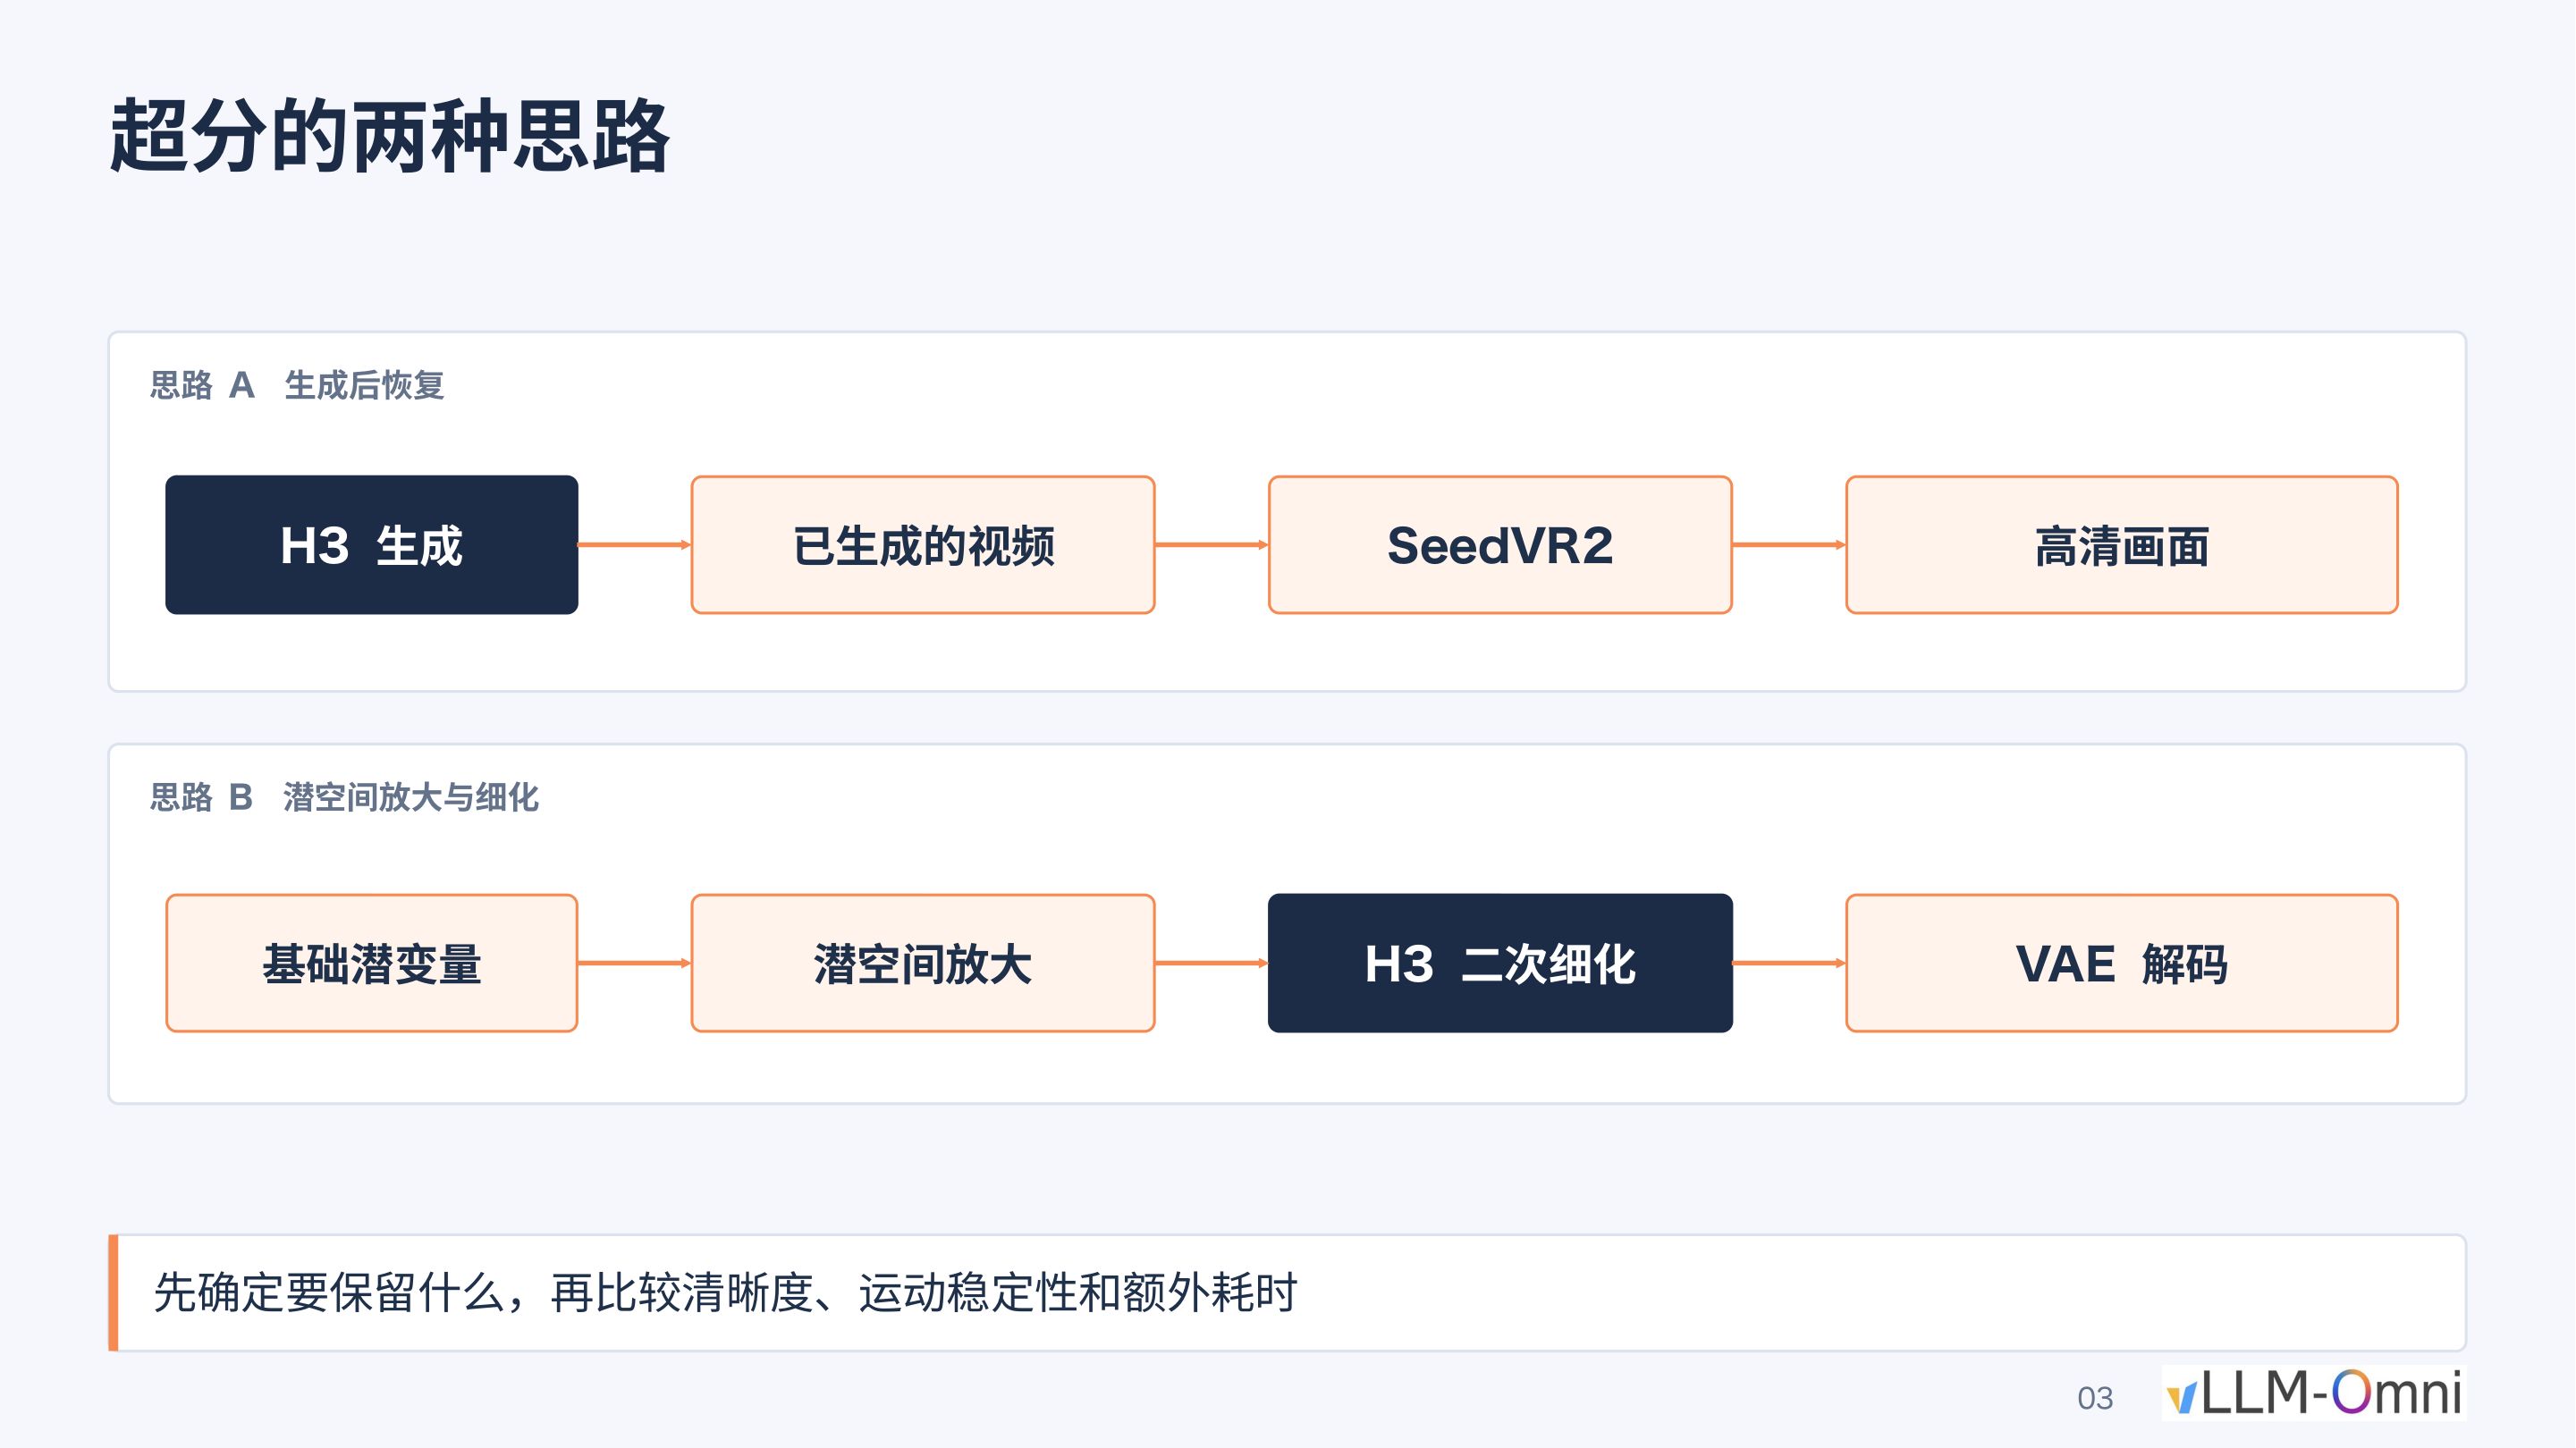 图注:超分的两种思路——思路 A(上)经由 SeedVR2 对已生成视频做像素级恢复;思路 B(下)在潜空间内放大后由 H3 二次去噪再经 VAE 解码。来源:演讲 PPT 第 3 页。
图中展示了两条完整的数据流:
| 路径 | 关键节点 | 操作空间 | 输出方式 |
|---|---|---|---|
| 思路 A 生成后恢复 | H3 生成 → 已生成视频 → SeedVR2 → 高清画面 | 像素空间 | 直接输出高清视频 |
| 思路 B 潜空间放大与细化 | 基础潜变量 → 潜空间放大 → H3 二次细化 → VAE 解码 | 潜空间 | 经 VAE 解码还原为像素 |
这里的潜空间(Latent space)指模型内部用于表示压缩数据的低维空间,其张量尺寸远小于对应的像素帧。两条路线的分歧点在于超分发生的空间不同,由此带来截然不同的画质—速度平衡。
机制拆解
思路 A:SeedVR2 像素级恢复。 SeedVR2(一种视频生成后恢复的高清超分模型)接收已经解码为像素的完整视频帧,在像素空间逐帧执行恢复。由于操作对象是最终像素,它能够在保留原始运动轨迹和色彩分布的前提下补充高频细节。代价显而易见:像素空间矩阵远大于潜空间矩阵,计算量和显存占用急剧上升。
思路 B:潜空间放大 + H3 二次细化。 该方案在潜空间中对基础潜变量做空间维度的放大,随后向放大后的潜变量注入噪声,再送回 H3 的 DiT(Diffusion Transformer,基于 Transformer 架构的扩散模型主干网络)执行第二轮去噪。因为潜空间张量尺寸远小于对应像素帧,整体延迟明显更低。
关键因果链条:潜空间放大 → 注入噪声 → H3 二次去噪 → 模型用自身训练先验"脑补"细节 → 画面风格被模型偏好所覆盖。正是这条路径,使输出不可避免地带上 H3 自身的生成风格。
视觉证据:人脸细节的真实差异
为直观展现两条路线在保真度上的差距,下图将同一素材的眼部区域在三种条件下进行了局部放大:
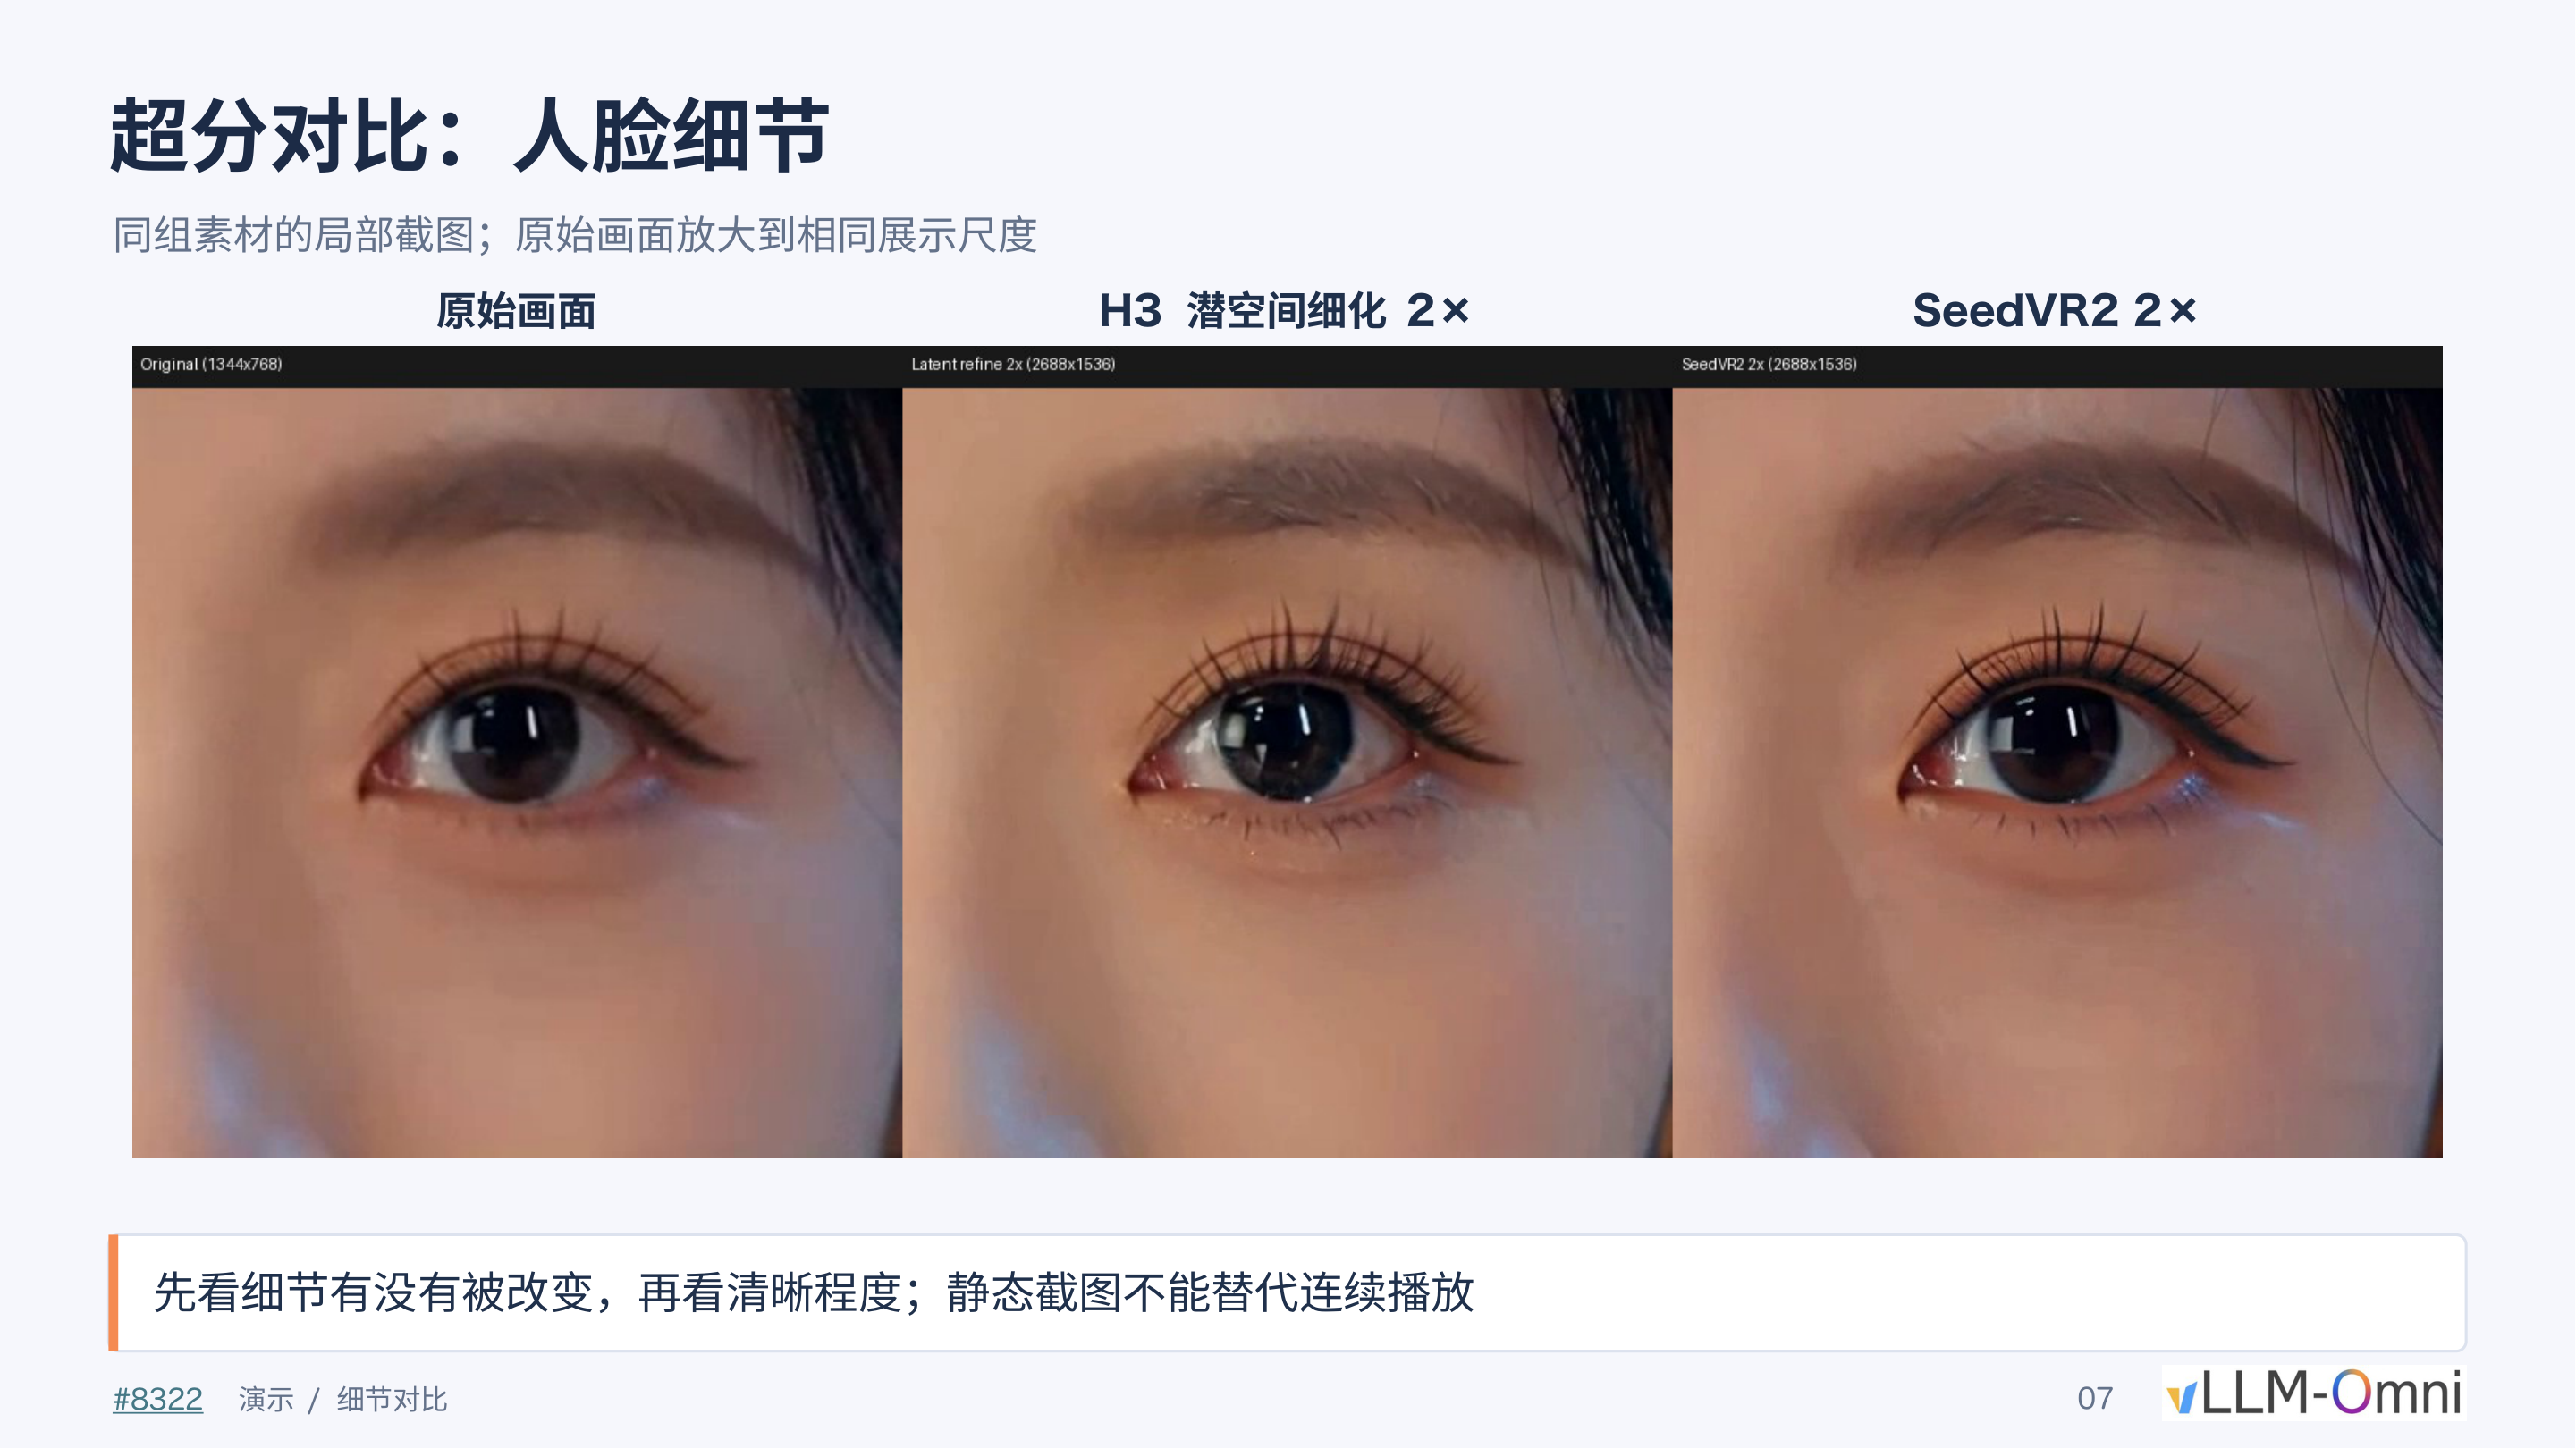 图注:同一素材在三种条件下的眼部局部放大对比(左:原始画面;中:H3 潜空间细化 2×;右:SeedVR2 2×)。来源:演讲 PPT 第 7 页。
从三列对比可以观察到两个层面的差异:
- 细节保留度。 中间列(潜空间细化)肤质趋于平滑,眼线与眼睑边缘出现涂抹感,整体偏向"2.5 次元"质感;右侧列(SeedVR2)更好地保留了皮肤纹理与高光位置。
- 色彩偏移。 潜空间细化在第二轮去噪过程中改变了整个画面的颜色分布;SeedVR2 仅在清晰度维度做增强,不系统性地改变色调。
需要注意:演讲材料明确提示"静态截图不能替代连续播放",在视频层面运动一致性与时序稳定性同样是评判维度,材料未给出连续帧的量化对比。
速度与保真的工程取舍
| 维度 | 思路 A(SeedVR2) | 思路 B(潜空间细化) |
|---|---|---|
| 操作空间 | 像素空间 | 潜空间 |
| 画面保真度 | 高:像素级细节与色彩均保留 | 中:二次去噪引入模型风格偏好 |
| 推理速度 | 慢:需运行独立超分模型 | 快:复用原模型,张量尺寸小 |
| 风格风险 | 低 | 高:易偏向短剧风 / 2.5 次元 |
| 部署复杂度 | 需额外加载 SeedVR2 权重 | 可在同一管线内完成 |
对于需要快速迭代的场景(如批量短视频),社区普遍选择思路 B,因其速度更快且无需额外模型。但对于严格保真的场景(如品牌广告、影视后期),思路 A 的像素级恢复几乎是唯一选择。
边界与小结
- 思路 B 的风格偏移并非 Bug,而是结构性限制:只要经过二次去噪,模型就会以训练分布中的先验去补全细节,这是 Diffusion 模型的固有行为。
- 思路 A 的瓶颈不在算法而在算力:SeedVR2 在像素空间处理完整视频帧,激活值规模极大。
- 演讲材料未给出两种路线的绝对耗时或 FLOPs 对比数据,具体加速比需根据部署硬件实测。
综上,768P 到 1080P 的超分是决定整条生成管线能否商用的关键环节。当保真度要求指向 SeedVR2 时,其带来的巨大计算负担就成为下一个必须攻克的工程问题。
击碎显存墙:窗口注意力在多卡间的重组
激活值把显卡撑爆
SeedVR2 参数量仅 3B,却在处理 15 秒视频时产生约 180 GB 的激活值(Activation,即前向计算各层需保留的中间张量)。这个数字远超任何单张 GPU 的显存上限。即使在 8 张 NVIDIA B300 上以朴素方式运行,一条 15 秒视频的超分仍需约 10 分钟。
瓶颈拆成两层:
- 容量问题:180 GB 激活值无法装入单卡,必须跨卡分摊。
- 效率问题:即便分摊后能运行,朴素切分带来的通信开销仍使端到端延迟居高不下。
为什么普通序列并行行不通
序列并行(Sequence Parallelism, SP)的一般思路是将输入序列沿 token 维度均匀切给多张 GPU,每卡只计算一部分注意力。但 SeedVR2 的注意力并非全局计算,而是两种操作交替执行:
- 窗口注意力(Window Attention):将三维 token 网格划为等大的局部窗口,每窗口内独立计算自注意力。
- 移位窗口注意力(Shifted-window Attention):将窗口网格整体偏移半个窗口步长后再划分,使相邻窗口的边界 token 得以交互。
沿 token 维度朴素均切时,同一窗口的 token 极可能被拆到不同 GPU,导致窗口内注意力无法本地完成,每层都需大量跨卡通信。更棘手的是:即使第一层把完整窗口对齐到同一张卡,进入移位窗口层后偏移操作会重新打散窗口归属,对齐前功尽弃。
机制解析:Window-aligned SP
针对上述矛盾,采用 Window-aligned SP 策略——以完整窗口为最小分配单元。下图展示了该方案在常规窗口与移位窗口之间的分配与通信逻辑:
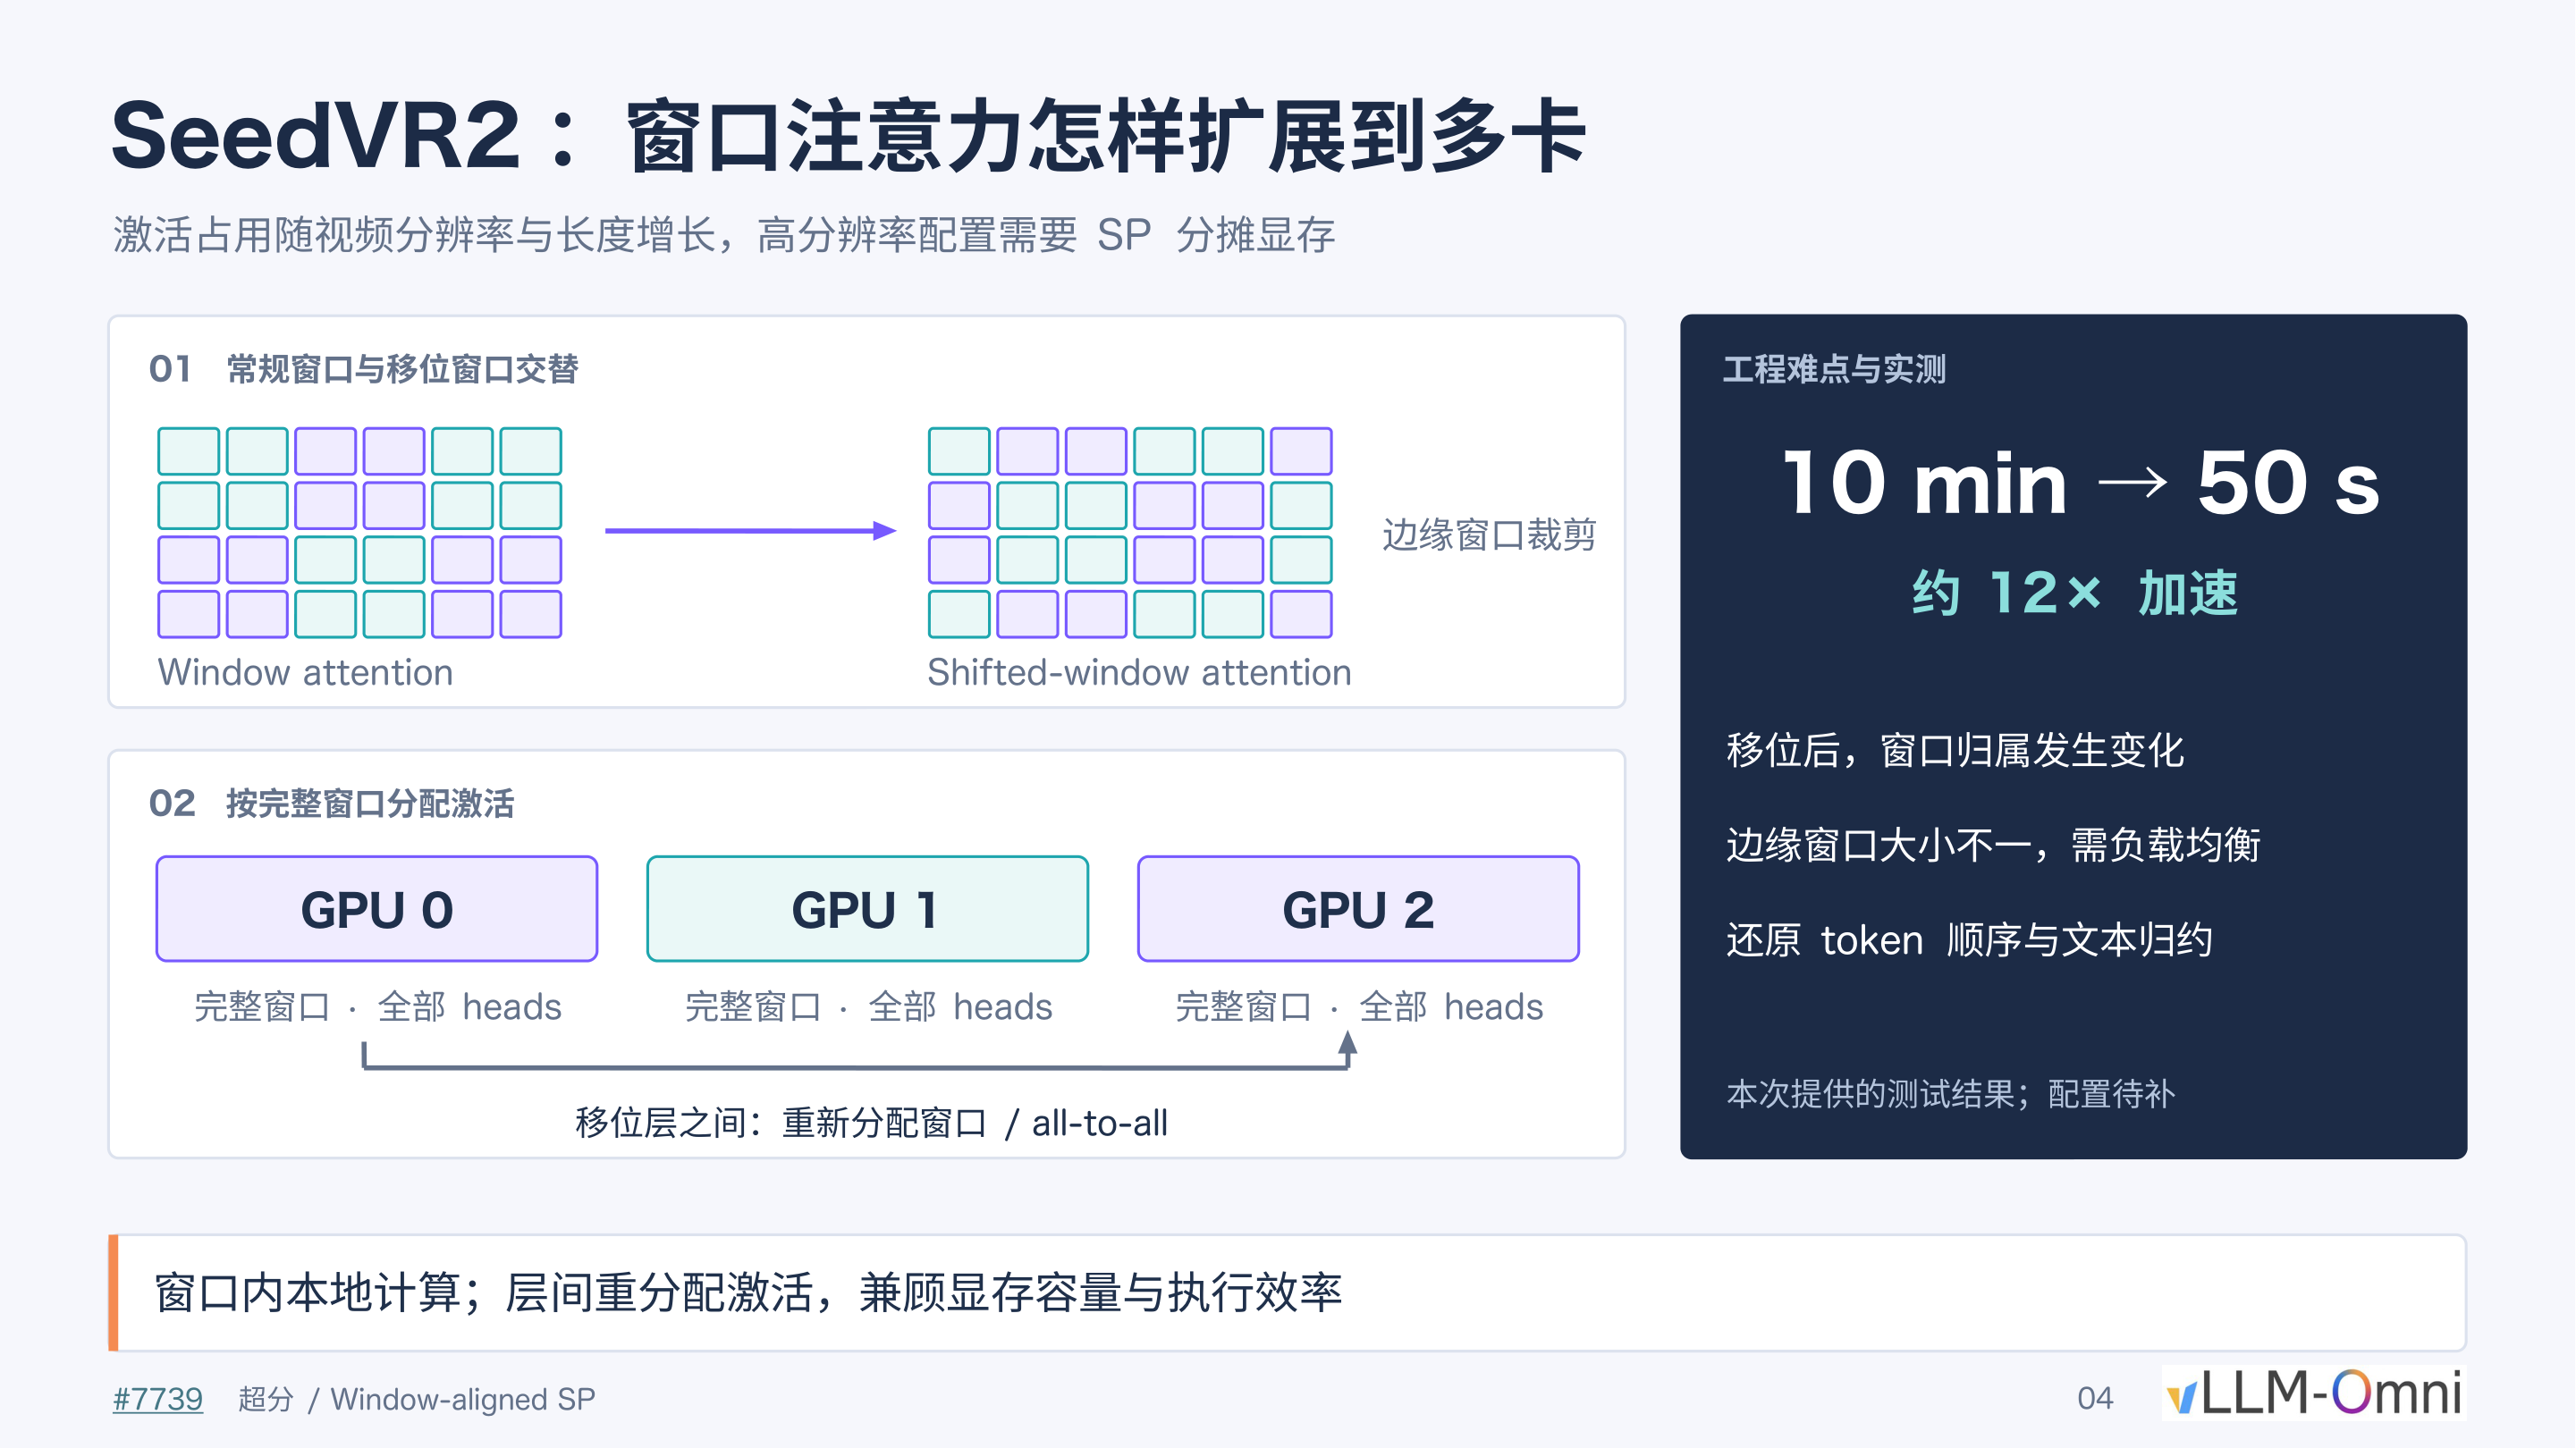 图注:Window-aligned SP 方案总览。左侧 01 区域展示常规窗口与移位窗口的交替关系及边缘裁剪;右侧 02 区域展示 GPU 0–2 各持有完整窗口与全部注意力头,层间通过 all-to-all 重新分配。来源:演讲 PPT 第 4 页。
图中关键元素的因果关系:
| 图中元素 | 含义 | 作用 |
|---|---|---|
| 01 区域两组网格 | 常规窗口划分 vs. 移位窗口划分 | 两种注意力交替出现,窗口边界在层间变化 |
| 边缘窗口裁剪标注 | 移位后网格边缘产生不完整窗口 | 碎片窗口大小不一,是负载均衡的难点 |
| 02 区域 GPU 0/1/2 色块 | 每卡分到若干完整窗口,保留全部 heads | 窗口内计算完全本地化,零跨卡通信 |
| 层间 all-to-all 箭头 | 移位层间对激活做重新搬运 | 按新窗口归属将 token 发送至对应 GPU |
执行流程为三步循环:
- 常规窗口层——每张 GPU 持有若干完整窗口,本地独立完成窗口内自注意力,无跨卡通信。
- All-to-all 重分配——进入移位窗口层前,根据偏移后的新窗口划分,通过 all-to-all 将 token 搬运到新归属的 GPU。
- 移位窗口层——重分配完成后各卡再次本地完成移位窗口注意力。
每层内部始终是纯本地计算,通信仅发生在窗口切换点。
三个工程难点
PPT 右侧面板标出了落地时须处理的具体问题:
- 窗口归属动态变化:每次移位后 token → GPU 映射全部改变,需动态计算 all-to-all 通信方案。
- 边缘窗口不等长:裁剪产生的碎片窗口使卡间 token 数量不均,简单按窗口数均分会引发负载倾斜。
- Token 顺序还原与文本归约:注意力计算完成后须将打散的 token 恢复原始顺序,并与文本条件信息进行归约。
性能锚点
在演讲者测试环境(8 张 NVIDIA B300)中,Window-aligned SP 将 15 秒视频超分耗时从 10 分钟降至约 50 秒,加速比约 12×。需要说明:演讲材料标注该测试的详细硬件配置"待补",上述数字来自演讲者口述的单次测试经验,不同卡型或分辨率下的结果尚未公布。
演讲者同时指出,180 GB 激活值规模下该操作在 B300 上仍为计算瓶颈(Compute-bound)而非访存瓶颈(Memory-bound),因此多卡并行加速比在不同设备上预计基本一致。实现细节可参考演讲中提及的 PR #7739。
边界与小结
Window-aligned SP 通过"按完整窗口分配 + 层间 all-to-all 重组",在不改变模型精度的前提下同时攻克了 SeedVR2 的显存容量与计算效率瓶颈。其适用边界在于:方案强依赖窗口注意力结构,对全局注意力模型不直接适用;边缘窗口的负载均衡在窗口尺寸与 GPU 数量的特定组合下可能需额外调优。
画质与分辨率的问题至此有了可行方案。但下一个商业痛点随即浮现:15 秒的时长限制远无法满足短剧或直播场景的需求,需要一种机制在不崩坏上下文的情况下持续续写。
跨越时间边界:长视频续写的条件注入与对齐
拼接断裂——15 秒窗口的工程痛点
MiniMax H3 原生支持最长 15 秒的单次生成。当创作者需要更长叙事时,最直觉的做法是将多段片段首尾拼接,但实际会遇到两类断裂:
- 镜头语言突变:前段的推轨方向、运镜节奏与后段不连贯,画面在拼接点出现跳切。
- 音频风格冲突:模型每段独立生成配乐,段间节拍与风格出现突变。
工程目标因此转为:在不重新训练的前提下,跨窗口连贯续写,理论上支持无限时长。
三步闭环
整个续写方案沿一条因果链展开——提取尾部条件 → 注意力交互 → 全局时间对齐,下面逐步拆解。
步骤一:尾部条件提取
上一窗口生成完毕后,系统直接在潜空间截取两组参考信号,而非解码为像素再重新编码:
| 信号类型 | 提取规则 | 后处理 | 输出 |
|---|---|---|---|
| 视频 latent | 取尾部 7 个时间格 | Patchify | 视频参考行 |
| 音频 latent | 按 40 Hz 全局边界切取尾部 | Pack | 音频参考行 |
为何是 7 帧?据演讲者说明,在 5 秒生成窗口下引入的前窗口帧数为 7,该值可通过参数调整。帧数本质上是"上下文充分性"与"有效新增时长"之间的平衡参数——取太少则续写缺乏运动参考,取太多则新内容占比降低。
在潜空间直接操作有两个好处:避免编解码往返的信息损失,并保持与后续 DiT 输入序列的格式一致。
步骤二:参考行与新窗口的注意力交互
提取完成后,系统将五类 token 拼接为一条完整的 DiT 输入序列,顺序如下:
- 文本 / 原始参考(用户 prompt 或参考图像)
- 尾部音频参考行
- 尾部视频参考行
- 新窗口音频噪声(待去噪目标)
- 新窗口视频噪声(待去噪目标)
在自注意力计算中,目标行的 Query 同时读取参考尾部与自身的 Key / Value,使新窗口的生成能感知前一段的末尾内容,从而延续镜头运动轨迹和音频走向。
关键约束:每轮去噪仅更新第 4、5 项(目标行),第 2、3 项(参考行)始终冻结。这确保已生成内容不会因续写而被反向篡改。
步骤三:RoPE 全局时间对齐
RoPE(Rotary Position Embedding,旋转位置编码,通过旋转矩阵将位置信息注入注意力计算)默认从零开始编码。若不做修正,模型会将每个续写窗口都当作"第 0–15 秒"来处理。对齐方式是在 RoPE 编码之前对时间坐标做全局平移:
- \(s\):当前窗口起始帧编号
- 40、24 分别对应音频 40 Hz 采样率与视频 24 FPS
- 仅平移时间维度,空间坐标保持不变
最小例子: 假设第 2 个续写窗口从第 238 帧起始,则所有 token 的时间位置编码需加上 \(238 \times 40/24 \approx 396.67\) 的偏移,保留小数以维持精度。
重叠部分的丢弃逻辑
新窗口的实际采样长度会包含与参考行在时间上重叠的区域。生成完毕后,系统丢弃新采样中与参考行重叠的部分,仅将不重叠的后缀追加到已有片段。丢弃而非替换的原因在于:重叠区域已有上一窗口的高质量结果,用新采样覆盖反而可能在拼接点引入不一致。
边界与小结
- 模型外推能力是前提。 演讲者指出此方案能生效的关键是 MiniMax H3 在训练阶段已具备较强的长时间外推能力。据其了解,部分开源视频模型不具备此特性,需额外后训练方可支持续写。
- 重叠帧数、窗口时长均可调整,数字人直播与短剧创作可能采用不同设定。
- 演讲材料未给出续写在极长时长(如数十分钟)下的画质衰减或累积误差的定量评估。
长视频续写的核心是将"拼接"问题转化为"条件生成"问题——在潜空间提取尾部条件提供视觉与音频上下文,通过注意力机制融合参考信号与新噪声,再借助 RoPE 时间平移维持全局时序一致性。然而随着分辨率和时长同时提升,系统的计算负载急剧上升,端到端延迟成为阻碍实时交互的核心矛盾。
榨干算力:稀疏注意力与多卡协同的组合
注意力的二次复杂度吞噬算力
视频生成模型推理阶段的计算热点集中在注意力层。以 MiniMax H3 为例,当生成 1344×768、24 FPS、30 秒的视频时,序列长度可达数十万 token 量级。注意力计算量与序列长度呈二次关系 \(O(n^2)\),分辨率或时长翻倍即可能带来四倍计算增长,单卡资源很快触顶。
核心问题由此浮现:能否跳过大部分冗余注意力计算,同时将剩余计算分摊到多张卡上?下图给出的组合方案把问题拆成两步——VSA 负责"砍掉不必算的",Ulysses 负责"把剩下的分给多张卡"。
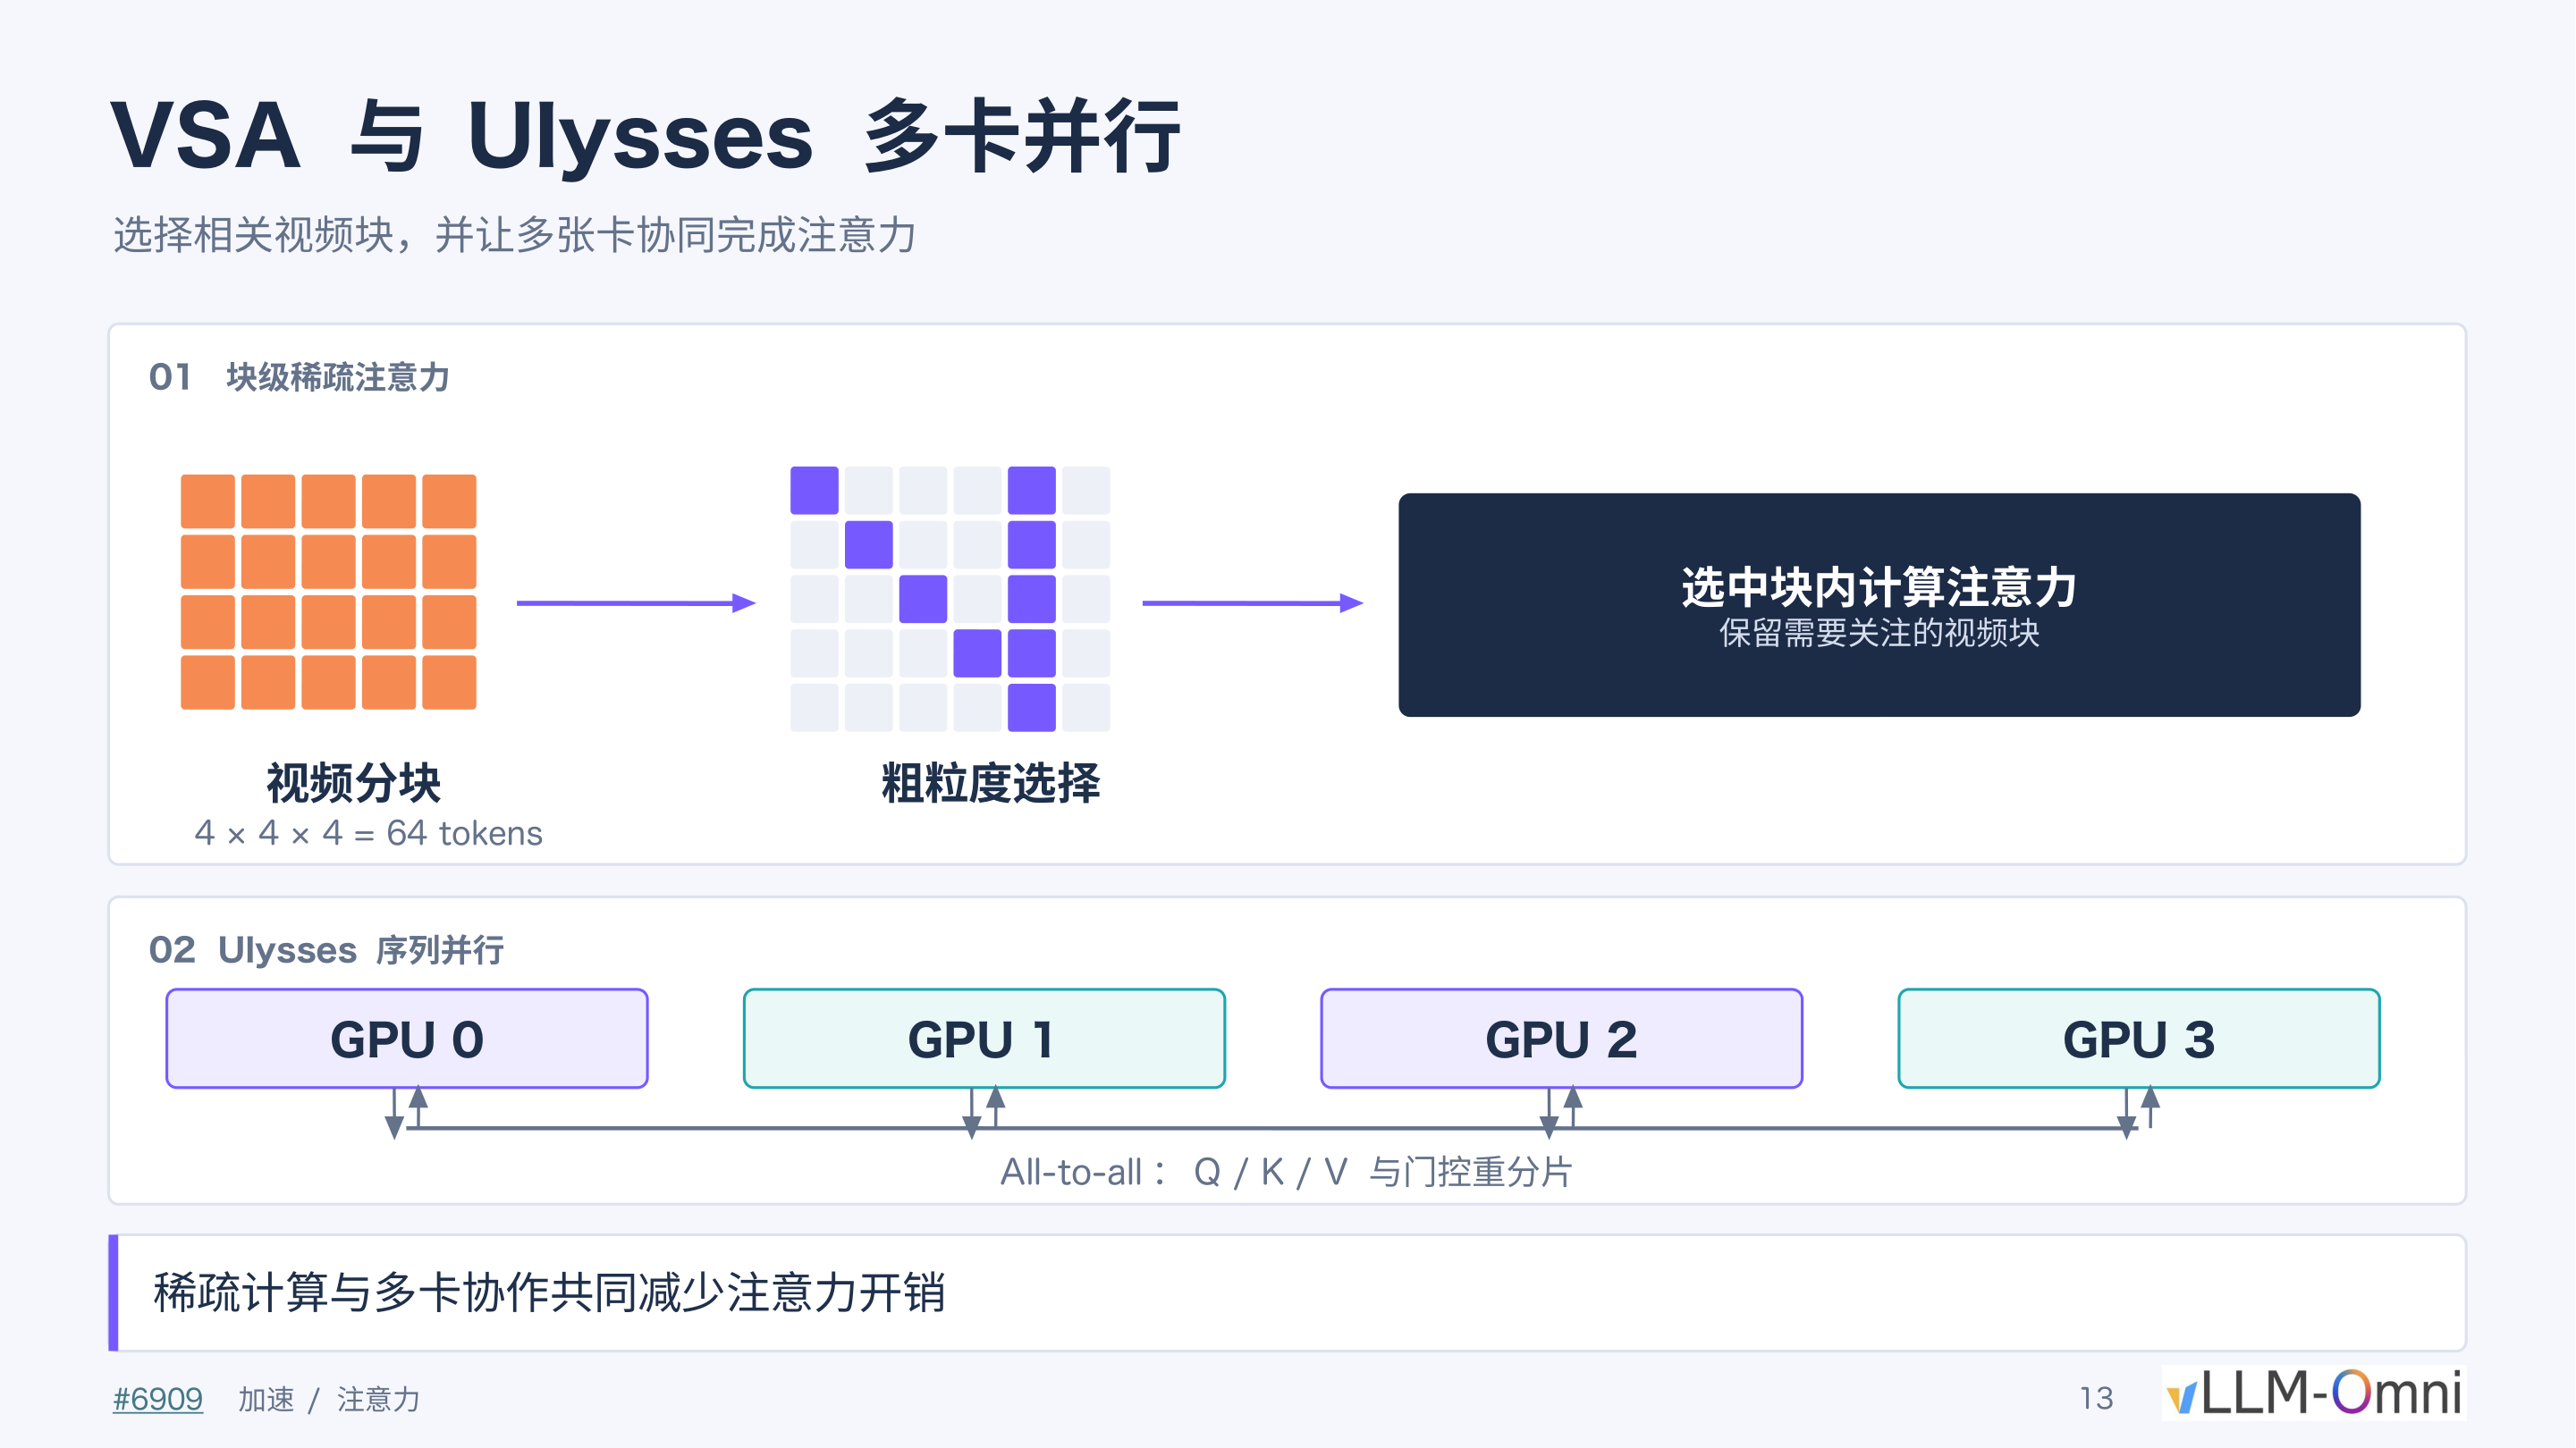 图注:左侧(编号 01)为 VSA 的分块、打分与筛选流程;右侧(编号 02)为 Ulysses 在 4 张 GPU 间通过 All-to-all 通信重分片 Q/K/V 的协同计算示意。来源:演讲 PPT 第 13 页。
01 VSA:块级稀疏注意力——先筛后算
VSA(Video Sparse Attention,块级稀疏注意力)是一种面向视频序列的稀疏注意力机制,其设计灵感与 DSA 的门控打分思路相似。如图左侧所示,流程分三步:
分块。 VSA 将视频张量沿时间、高度、宽度三个维度切分为固定大小的块,每块 4 × 4 × 4 = 64 个 token。
门控打分与粗粒度选择。 模型对每个视频块执行门控评估,输出该块与当前 Query 的相关性得分,仅保留 top-k 高分块进入注意力计算,其余直接跳过。
选中块内精细注意力。 只在被保留的块之间执行标准注意力运算,等价于将 \(n \times n\) 注意力矩阵压缩为一个远小于 \(n\) 的稀疏子矩阵。
| 步骤 | 操作 | 粒度 | 作用 |
|---|---|---|---|
| 分块 | 4 × 4 × 4 切分 | 64 tokens/块 | 提升调度粒度 |
| 打分 | 门控评估相关性 | 块级 | 识别高信息量区域 |
| 筛选 | 保留 top-k 块 | 块级 | 跳过冗余区域 |
| 计算 | 选中块间做注意力 | token 级 | 保留生成精度 |
演讲材料未给出 top-k 占总块数的具体比例。
02 Ulysses:序列并行——多卡分摊剩余计算
稀疏化之后的序列仍可能超过单卡承载能力。Ulysses 是一种序列并行技术,通过对 Q/K/V 做 all-to-all 交换实现多卡协同注意力。如图右侧所示,4 张 GPU 按以下流程协同:
- 按序列分片——每张卡持有序列的 1/4,本地计算对应的 Q / K / V。
- All-to-all 通信——各卡将片段进行重分片,通信后每张卡获得完整序列但仅覆盖一部分注意力头。
- 并行注意力——各卡在各自负责的注意力头上独立完成稀疏注意力运算。
- 逆向 All-to-all——结果交换回原始的序列分片布局,供后续层继续处理。
"先按序列切,通信后按头切"的策略使任何一张卡都无需保存完整 K/V 矩阵,显存与计算均匀分摊。
组合效应与边界警示
VSA 与 Ulysses 是串联而非互斥的关系:VSA 做减法——缩短有效序列;Ulysses 做除法——将缩短后的计算量均分到 N 张卡。二者叠加后,注意力层的总计算量和单卡峰值显存同时下降。
但注意力内核即使大幅提速,整体推理时间未必同比缩短。在以下测试条件下——8 × SM120 GPU、FastH3 VSA、生成 30 秒、1344×768、24 FPS——将注意力后端替换为 FlashInfer BF16 内核后的实测结果:
| 度量层级 | 加速倍数 |
|---|---|
| 稀疏注意力内核 | 3.43× |
| HTTP 端到端请求延迟 | 1.14× |
内核提速约 3.4 倍,端到端却仅缩短约 14%。差距的根源在于注意力之外的环节——数据传输、非注意力层运算、调度等待——在总耗时中仍占主要份额。这正是 Amdahl 定律的典型体现:被优化部分占比有限时,局部加速的全局收益被大幅稀释。
小结
VSA 以 64 token/块为单位进行门控打分与 top-k 筛选,将全量注意力压缩为稀疏子集;Ulysses 通过 All-to-all 通信在多卡间重分片 Q/K/V,实现序列级并行。但 3.43 倍内核加速最终仅转化为 1.14 倍端到端提速,表明注意力之外的计算环节已成为新的瓶颈——例如为 Attention 和 MLP 生成控制参数的时间步投影模块,其冗余计算需要专门的缓存手段来消除。
拒绝重复造轮子:时间步投影的精确缓存机制
问题:每轮去噪都在重算相同的投影
视频生成模型在推理阶段需要执行数十轮去噪迭代。每一轮中,DiT 的每个 block 都要根据当前时间步 \(t\) 算出一组控制参数,用于调节 Attention 与 MLP 分支的行为。关键矛盾在于:这些投影运算不依赖当前画面的 token 内容,只取决于时间步条件本身。如果两次请求碰巧使用相同的时间步与模型环境,投影输出完全一致,重算便是纯粹的浪费。
AdaLN 投影:从时间步到六组控制参数
AdaLN(Adaptive Layer Normalization,自适应层归一化)是 DiT 中将时间条件注入每个 Transformer block 的核心机制。下图展示了 AdaLN 如何将单一时间步映射为六组参数并调制网络行为:
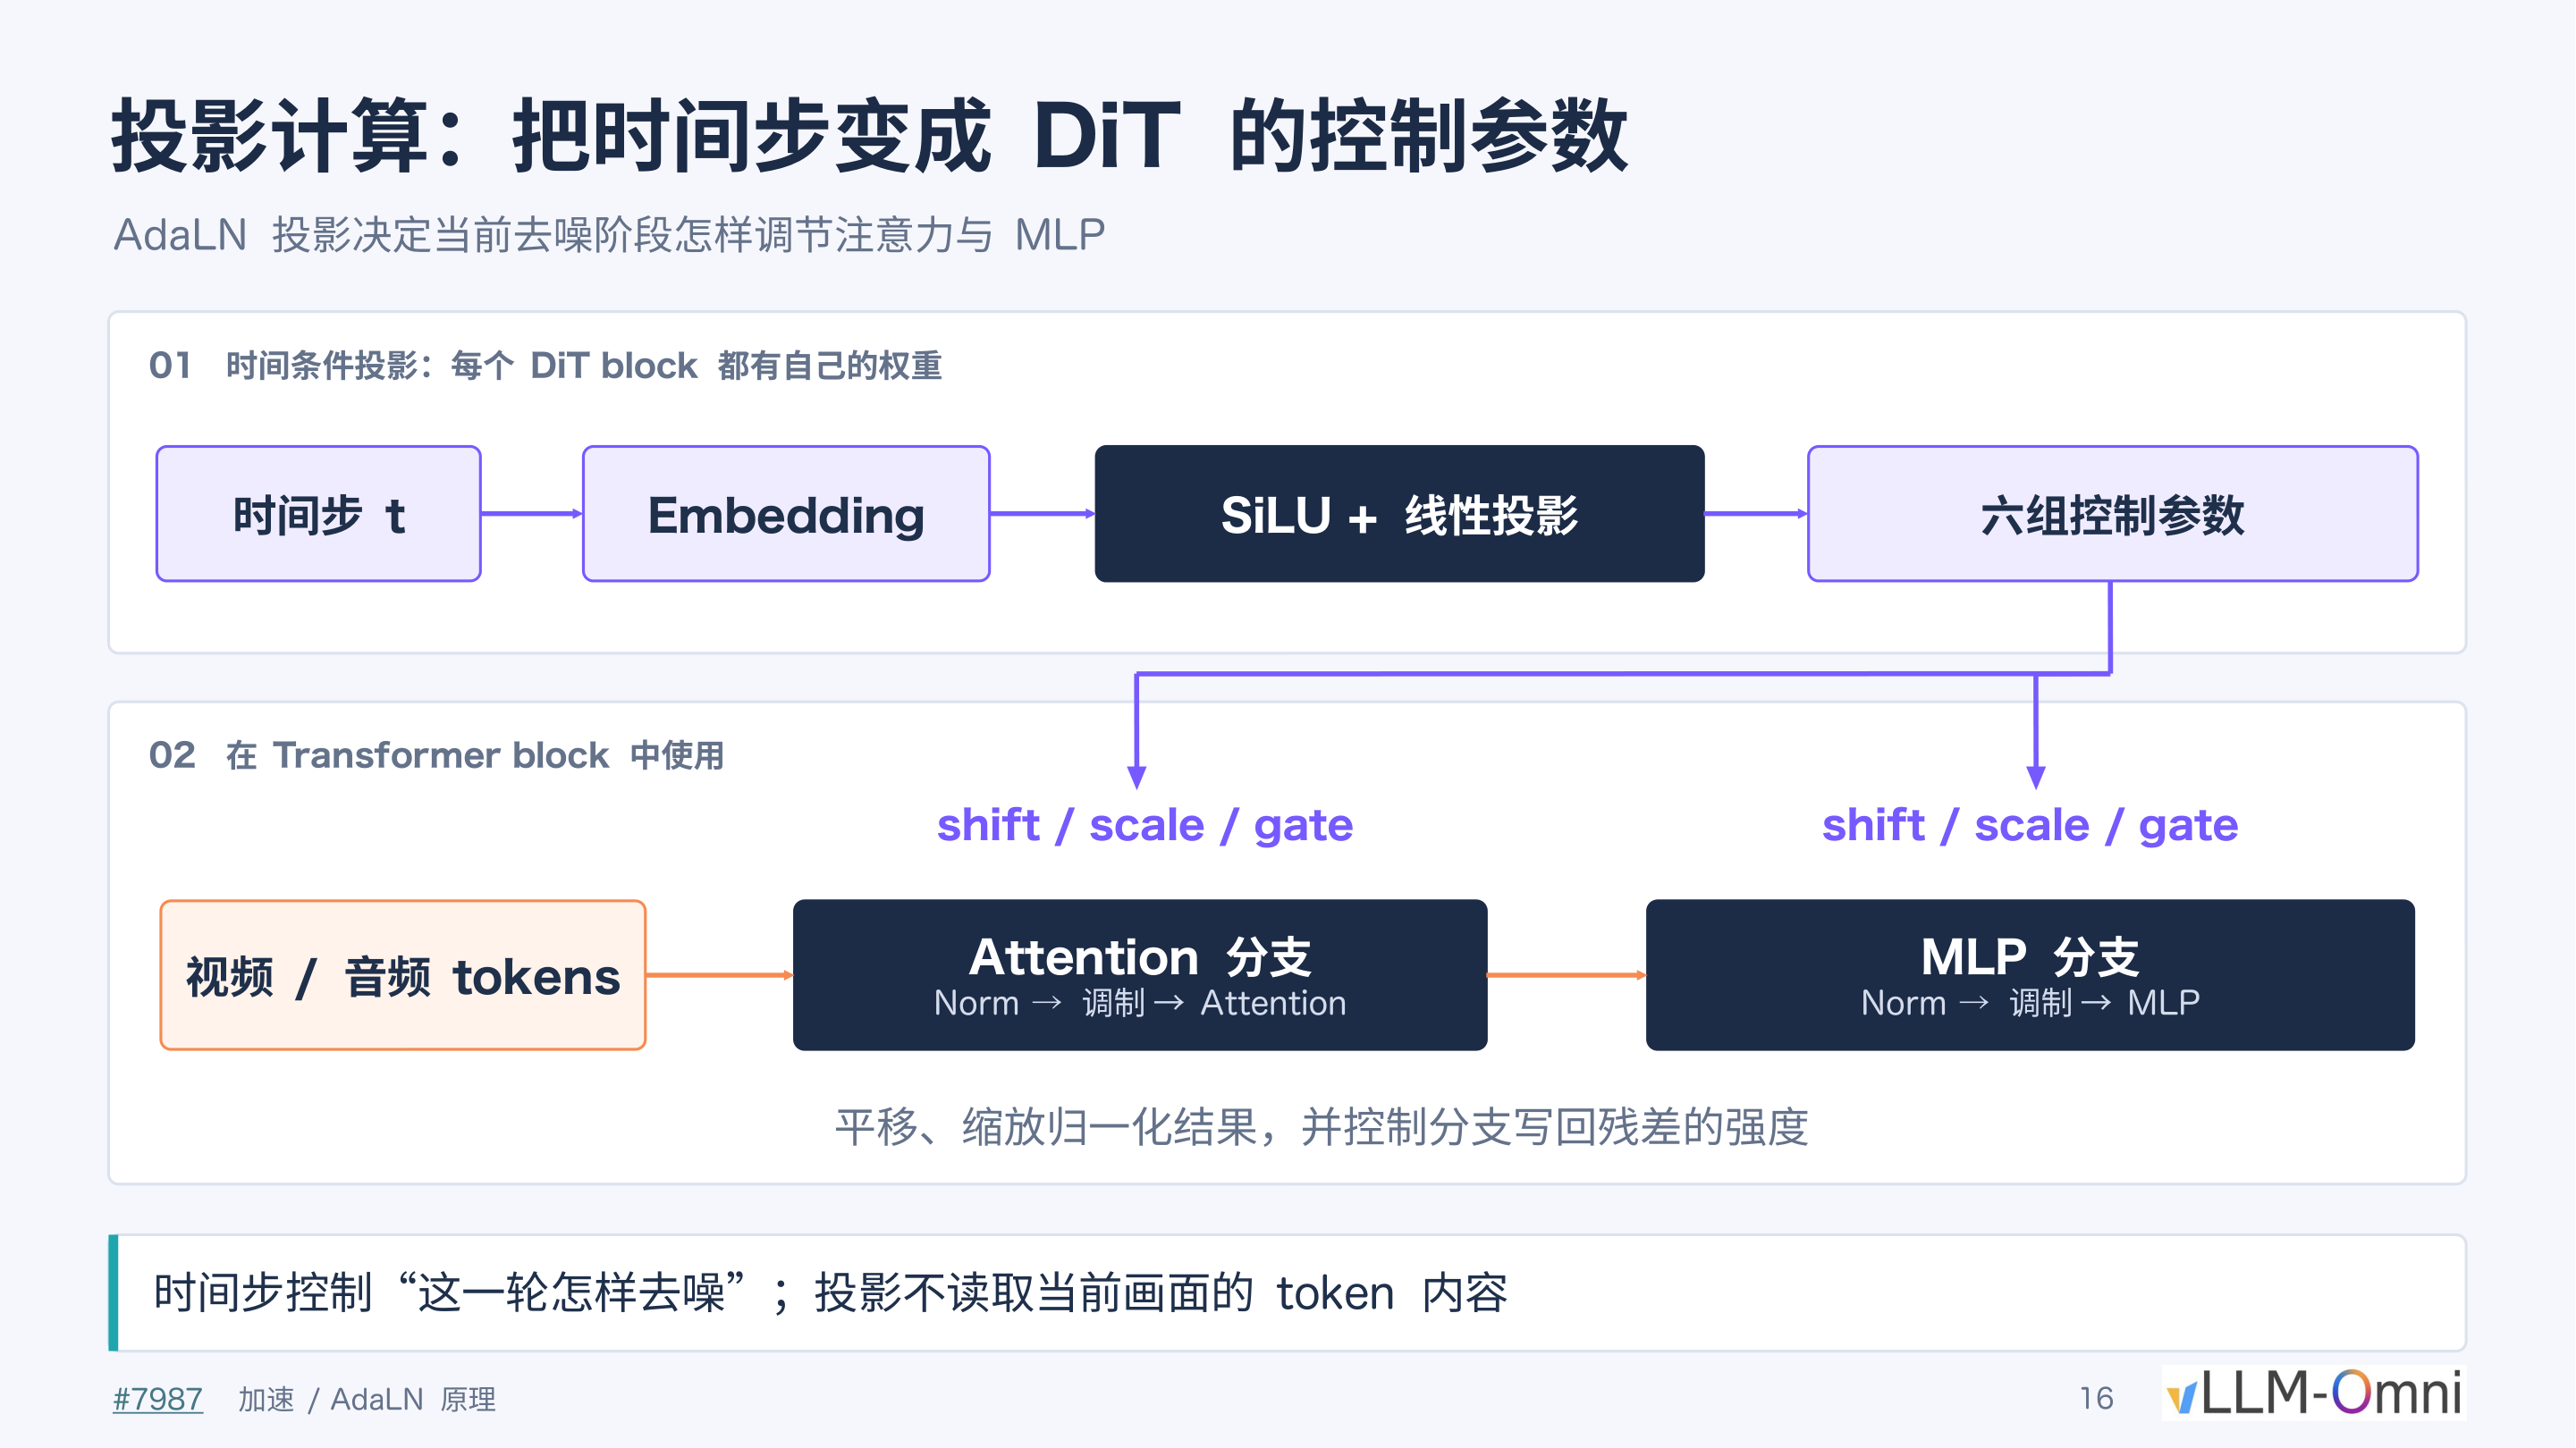 图注:AdaLN 投影流程及其在 Transformer block 中的作用。来源:演讲 PPT 第 16 页。
图中分为两个阶段:
| 阶段 | 输入 | 操作 | 输出 |
|---|---|---|---|
| ① 时间条件投影 | 时间步 \(t\) | Embedding → SiLU 激活 → 线性投影 | 六组控制参数 |
| ② Block 内调制 | 视频/音频 tokens | Norm → 调制 → Attention / MLP | 调制后的残差输出 |
六组参数按功能分为两组各三个:shift(平移)、scale(缩放)、gate(门控)。前三个作用于 Attention 分支,后三个作用于 MLP 分支。shift 和 scale 改变 LayerNorm 输出的分布,gate 控制该分支写回残差流的强度。每个 DiT block 持有独立的投影权重,因此同一时间步在不同 block 中产出的参数各不相同。
要点:投影过程完全不读取当前画面的 token 内容,输出仅由时间步 \(t\) 和本层权重决定——这正是缓存可行的前提。
精确校验:命中条件与多卡一致决策
缓存的核心难点不在"存",而在"何时可以取"。一旦数值环境发生任何微小变化,复用旧结果就会引入累积误差。下图给出了完整的命中判定流程:
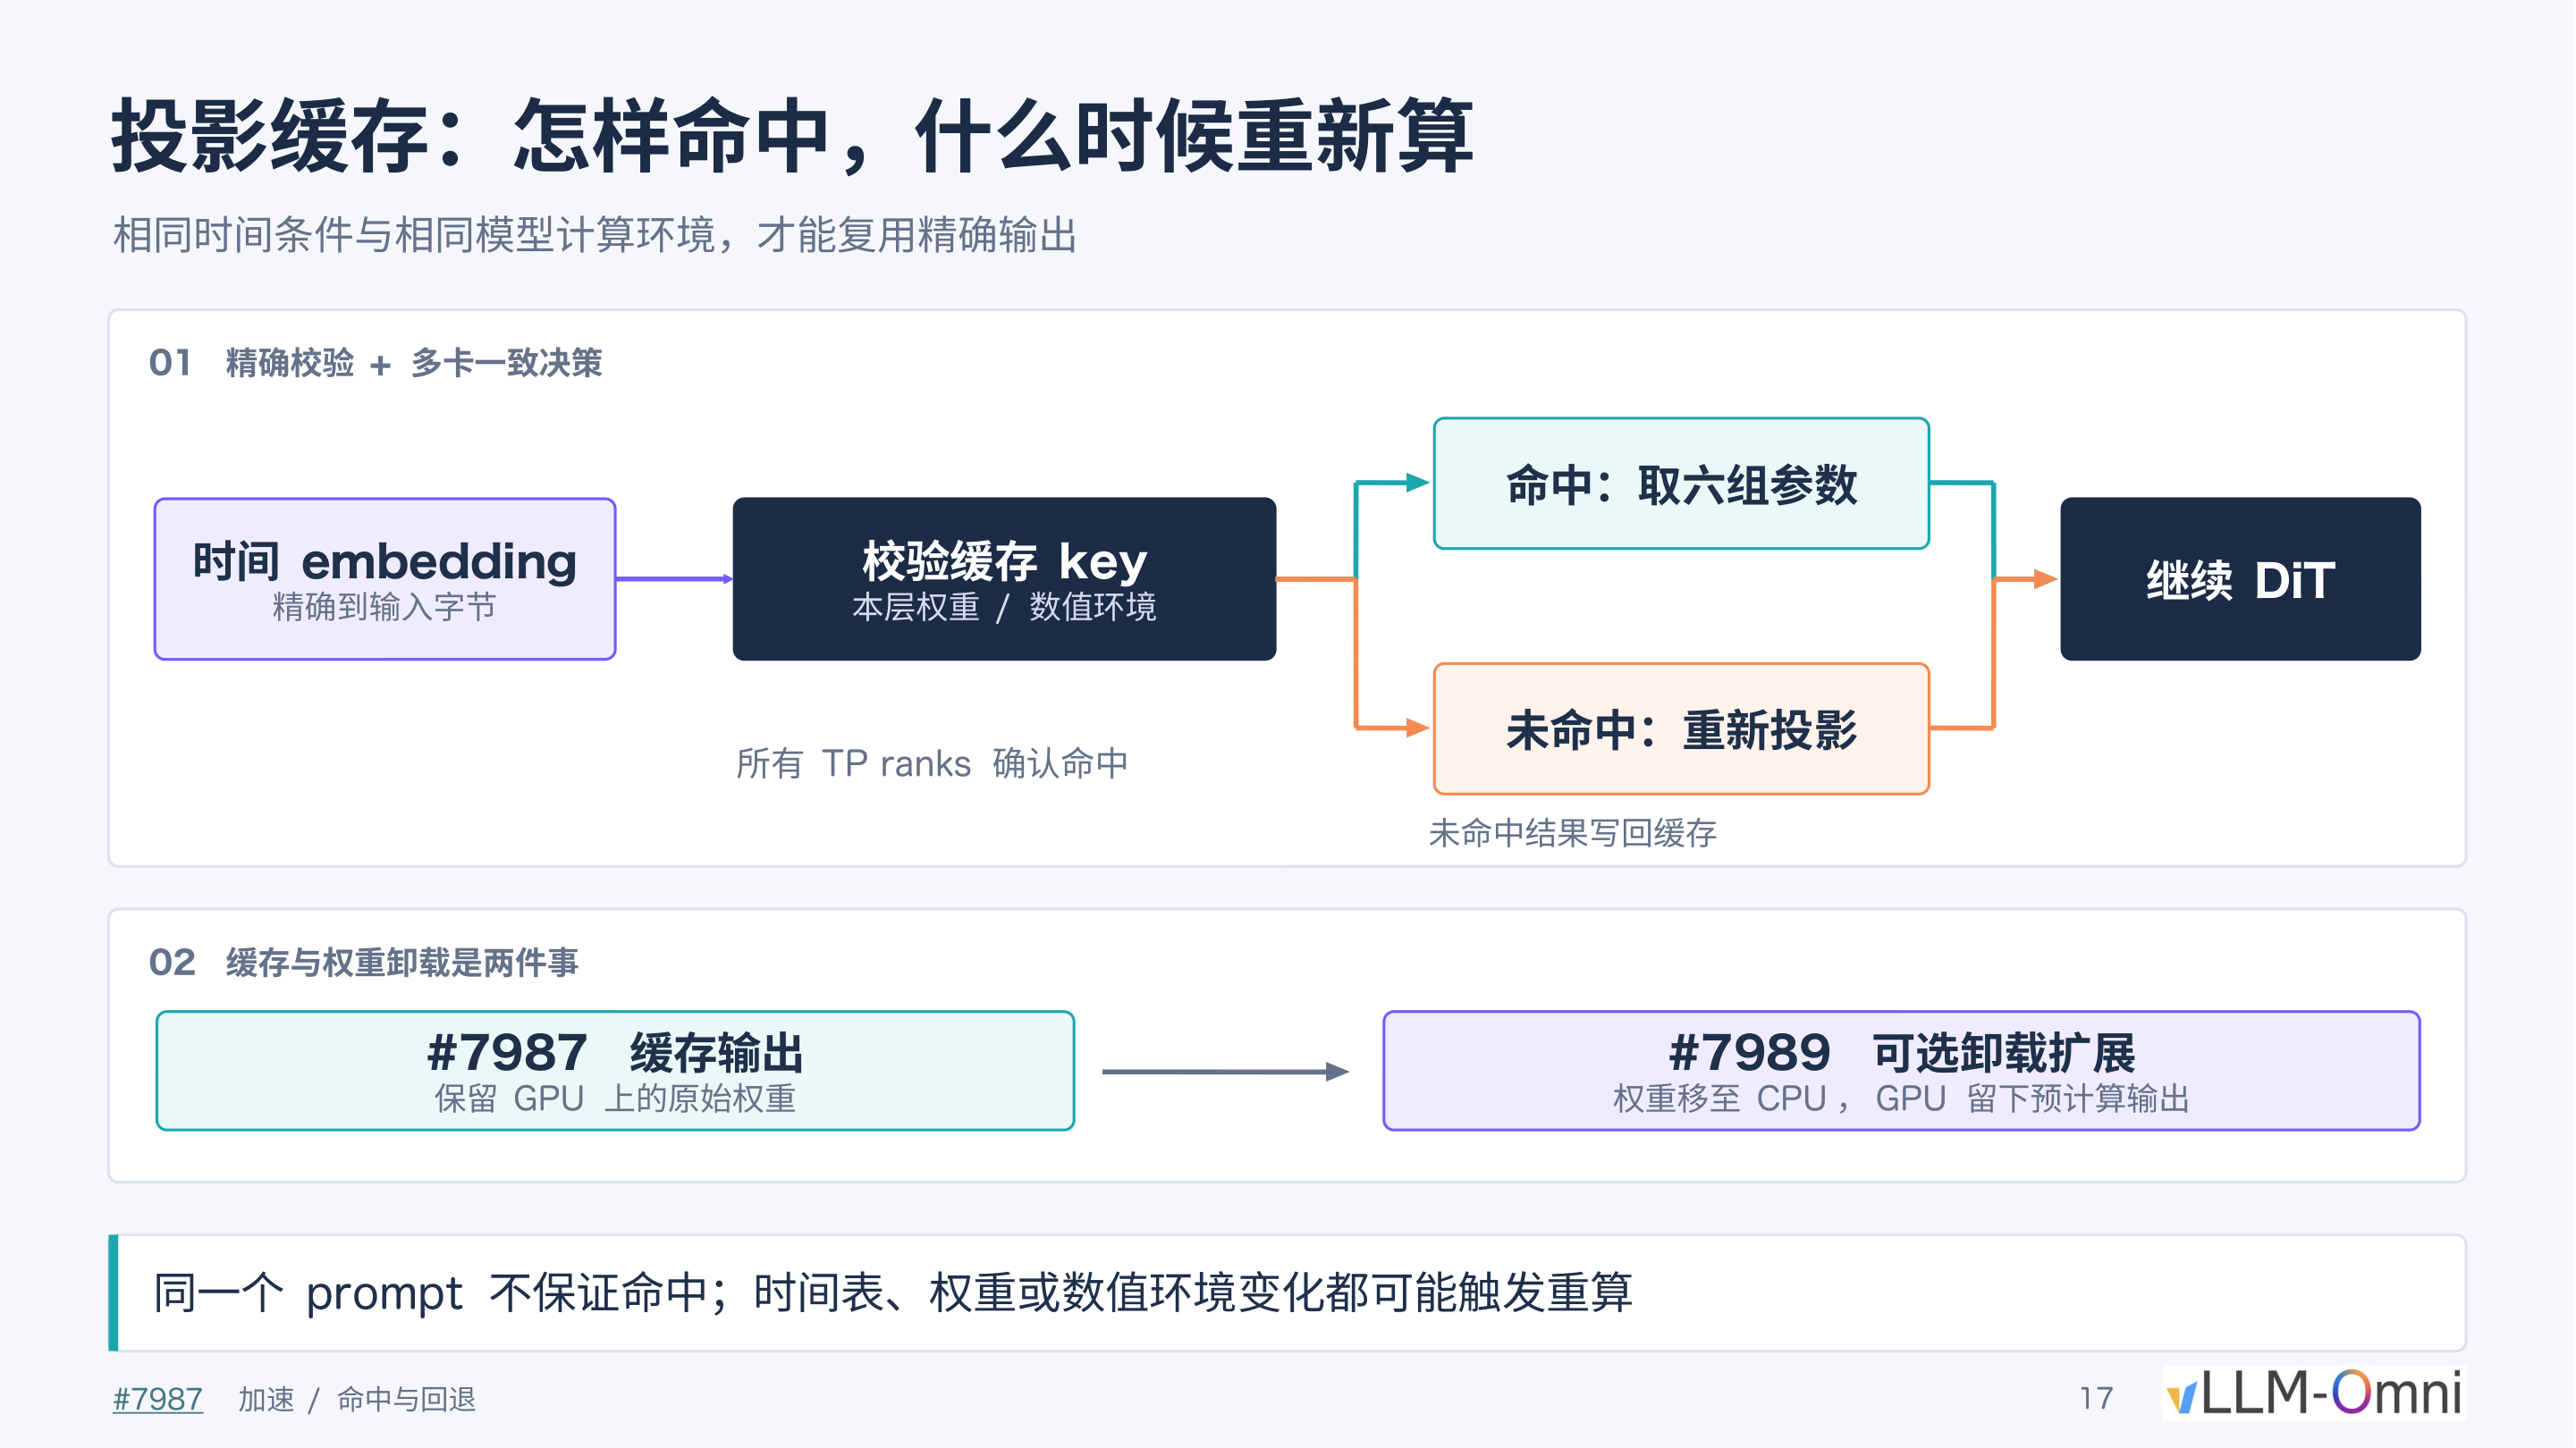 图注:投影缓存的精确校验与回退机制。来源:演讲 PPT 第 17 页。
流程沿图中箭头展开:
- 构造校验 key——将时间 embedding 精确到输入字节,与本层权重及当前数值环境(如精度模式)一起拼成缓存键。
- 多卡一致决策——在张量并行(TP)场景下,所有 TP ranks 必须同时确认命中,才允许取出缓存的六组参数;任意一张卡判定未命中,则全部回退到重新投影。
- 未命中时写回——重新计算的结果写入缓存,供后续请求查询。
精确校验的三个维度:
- 时间 embedding:字节级比对,不做近似匹配。
- 本层权重:若模型经过微调、LoRA 合并等操作导致权重变化,缓存自动失效。
- 数值环境:包括浮点精度设定等运行时状态,任何变动都触发重算。
图中第二部分(标注 02)还区分了缓存输出与可选的权重卸载扩展:前者保留 GPU 上的原始权重,仅额外存储投影结果;后者将权重迁移到 CPU,GPU 端只留预计算输出。两者可独立配置。
边界与小结
| 边界条件 | 说明 |
|---|---|
| 同一 prompt 不保证命中 | 不同采样调度器可能产生不同的时间步序列 |
| 时间表变更 | 切换去噪步数或噪声调度策略,时间 embedding 随之改变 |
| 权重或精度变更 | 模型热更新、量化方案切换均触发缓存失效 |
演讲材料未给出该缓存机制的具体加速比数据,但从机制上看,每次命中可为每个 DiT block 省去一次 Embedding + SiLU + 线性投影的完整前向计算,在 block 数量较多的深层模型中节省量可观。
投影缓存的本质是在"绝对正确"的约束下做惰性求值,与注意力层或 MLP 层的计算优化正交,可叠加使用。GPU 侧的计算至此已被多维度压缩,但如果数据卡在向 CPU 传输的最后一公里,实时交付依然无从谈起。
最后一公里的竞速:数据搬运与格式转换前置
被忽视的尾部瓶颈
经过注意力稀疏化、投影缓存、多卡并行等一系列优化之后,扩散模型的去噪阶段已经相当快。然而在早期版本中,工程团队发现一个反直觉的现象:端到端交付时间仍然异常缓慢。瓶颈不在 GPU 计算,而在推理完成之后、视频文件写出之前的数据搬运与格式转换过程。据演讲者描述,该问题大约在项目第一周就被排查定位,其严重程度甚至被视为一个 Bug。
原始数据流:四倍冗余的搬运
问题出在视频帧输出的处理流程上。优化前,数据流如下:
- GPU 解码:模型在 GPU 上完成去噪与 VAE 解码,输出像素级结果,数据格式为 FP32(单精度浮点数,每个数值占 4 字节)。
- FP32 传输:整批 FP32 数据从 GPU 显存经 PCIe 总线搬运至 CPU 主存。
- CPU 格式转换:在 CPU 侧将 FP32 逐元素转为 uint8(无符号 8 位整数,每个数值占 1 字节,取值 0–255,对应像素亮度)。
- 编码:转换后的 uint8 数据送入 MP4 编码器。
关键矛盾在于第 2 步和第 3 步的组合:FP32 表示下视频像素数据体积可达数 GB,经 PCIe 总线搬运到 CPU 后还要逐帧做浮点到整型的截断与缩放——既浪费带宽,又占用 CPU 算力。
修复方案:转换前置至 GPU
下图对比了修复前后的数据搬运路径,直观展示传输量的变化:
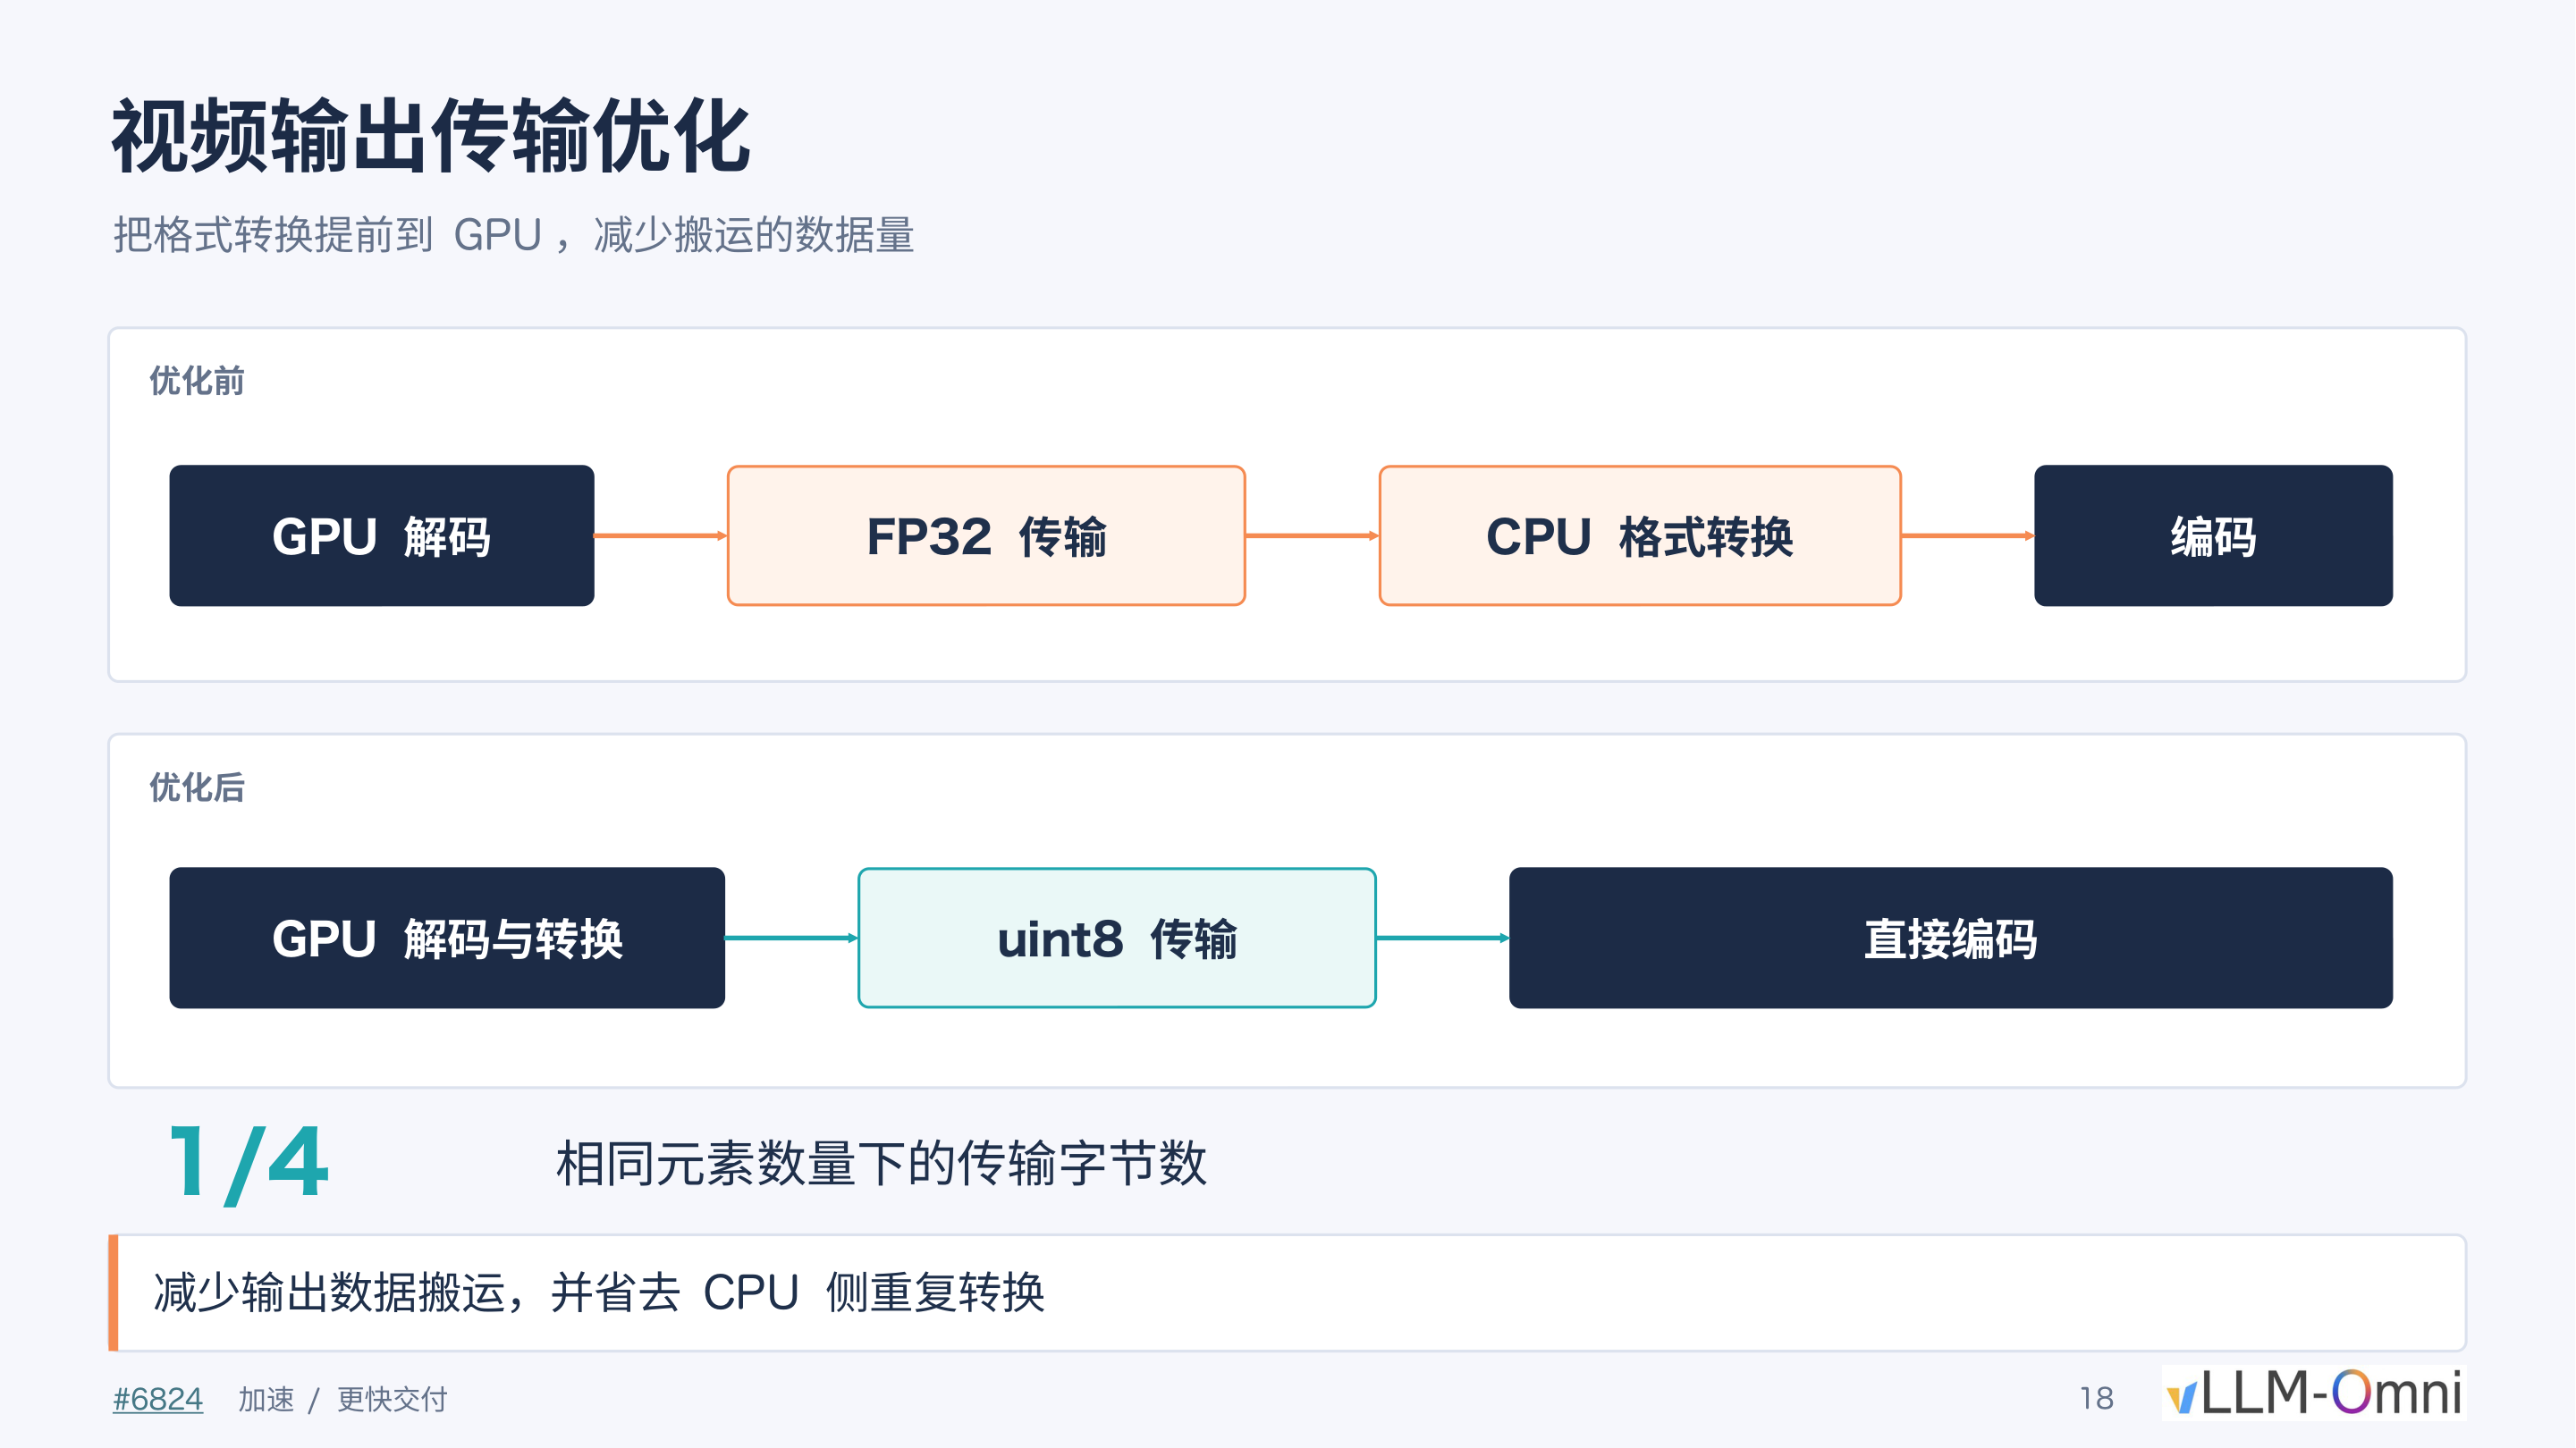 图注:优化前后的数据搬运路径对比。左侧为原始流程(GPU 解码 → FP32 传输 → CPU 格式转换 → 编码),右侧为优化后流程(GPU 解码与转换 → uint8 传输 → 直接编码)。来源:演讲 PPT 第 18 页。
修复思路非常直接:把 FP32→uint8 的格式转换提前到 GPU 上完成,然后再搬运。
| 对比项 | 优化前 | 优化后 |
|---|---|---|
| 转换位置 | CPU | GPU |
| 传输数据类型 | FP32(4 字节/元素) | uint8(1 字节/元素) |
| 相同元素数的传输量 | 基准 | 1/4 |
| CPU 侧转换开销 | 需要 | 省去 |
FP32→uint8 本质上是一次值域映射(将浮点 [0.0, 1.0] 线性缩放至整型 [0, 255]),计算量极低,GPU 上一次简单 kernel 即可完成,几乎不增加显卡负担。而搬运 4 倍数据量造成的延迟和 CPU 侧串行转换的开销,才是实打实的端到端瓶颈。
最终性能锚点
在消除搬运瓶颈并结合全链路优化后,系统达到了如下实测表现:
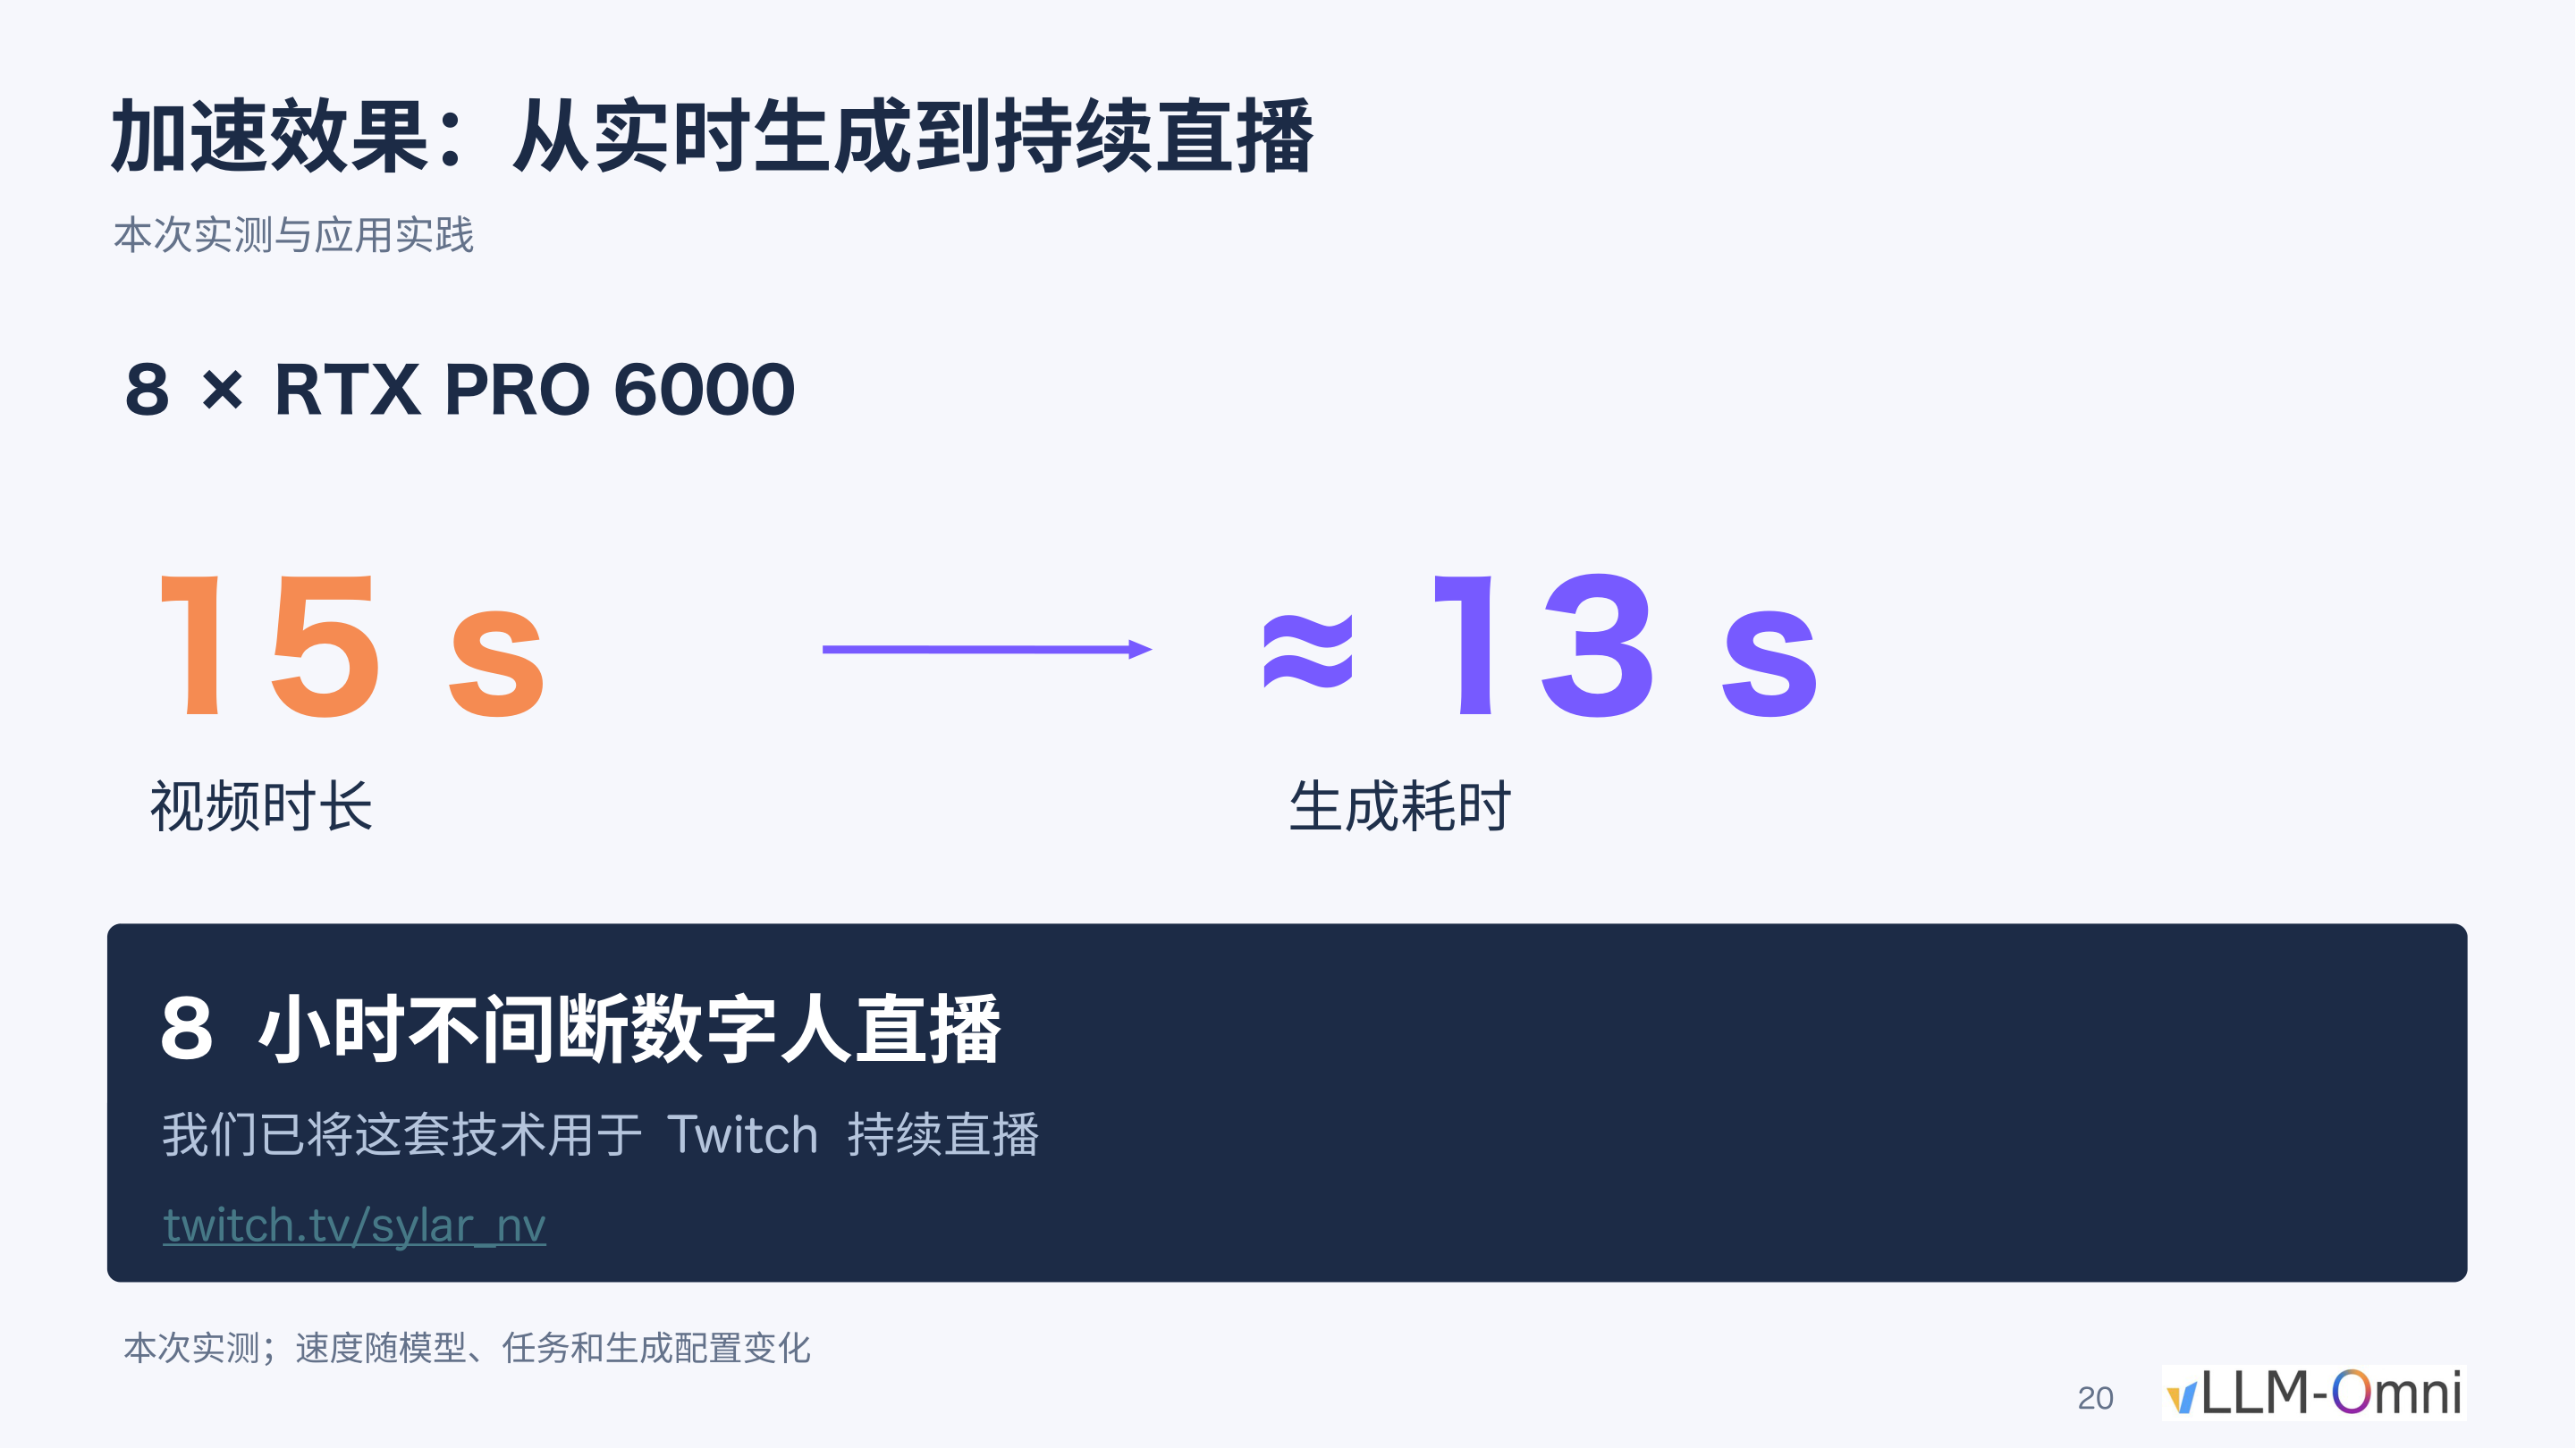 图注:最终性能实测数据。硬件为 8 × RTX PRO 6000,生成 15 秒视频耗时约 13 秒,并支撑了 Twitch 平台上 8 小时不间断数字人直播。来源:演讲 PPT 第 20 页。
核心指标:
- 硬件配置:8 张 NVIDIA RTX PRO 6000
- 生成速度:15 秒视频 ≈ 13 秒生成耗时——生成速度超过播放速度,达到实时
- 稳定性验证:该配置在 Twitch 上完成了 8 小时不间断的数字人直播
需要注意以下限定条件:该次直播尚未集成 SeedVR2 超分模块;速度随模型版本、任务和采样参数变化;演讲者判断加入超分后很难维持当前的实时生成速度。
边界与小结
这一案例揭示了一个工程中常见但容易被忽视的规律:当核心计算被充分加速后,数据搬运和格式转换等"胶水"环节反而成为新的主导瓶颈。修复方法本身并不复杂——仅需将一步轻量转换移至数据所在的设备——但发现它需要对端到端链路的逐段计时与排查。
底层推理引擎的速度与质量至此已经就绪。但要让普通用户和业务系统真正使用这些能力,还需要上层的封装与编排。
封装复杂性:从节点工作流到多 Agent 编排
优化做完了,用户怎么用?
前面各节讨论的推理加速技术均发生在框架内部。站在创作者视角,真正的痛点是:
- 复现难:社区分享的效果往往依赖特定参数组合与手工脚本,缺乏可复用的操作链路。
- 重复劳动多:局部编辑、视频延展、分镜拼接等高阶能力需要反复手动配置。
- 全流程断裂:即使单次生成够快,从创意文案到成品视频仍需人类在多个工具间来回切换。
为解决上述问题,vLLM-Omni 在两个层次进行了封装:节点层用 ComfyUI(一个基于节点的工作流图形界面,广泛用于 Diffusion 模型的图像与视频生成)暴露可视化操作单元;编排层用 JiuwenSwarm(一个多 Agent 框架,用于分析和编排任务,可调用 ComfyUI 工作流实现自动化视频生成)让 AI 代替人类完成重复配置。
节点层:ComfyUI 掩码编辑工作流
vLLM-Omni 提供了原生的 ComfyUI 节点(核心代码位于 apps/ComfyUI-vLLM-Omni/comfyui_vllm_omni/nodes.py),可直接替换社区已有工作流中的对应模块,同时继承框架的多卡部署与推理优化能力。
演讲 PPT 第 22 页展示了一条局部编辑工作流的界面截图(PR #7898),其数据流可概括为如下闭环:
| 阶段 | 节点功能 | 输出 |
|---|---|---|
| ① 源视频输入 | 加载待编辑的视频帧序列 | 原始帧张量 |
| ② 掩码生成 | 用户绘制或算法生成遮罩区域 | 二值掩码(Masking,用于指定需要修改的视频区域)张量 |
| ③ 预览 | 将掩码叠加到原始帧上供确认 | 可视化预览 |
| ④ 扩散采样 | 在掩码区域内执行条件生成 | 编辑后帧序列 |
| ⑤ 视频输出 | 拼合编辑区域与未改动区域 | 最终视频文件 |
关键因果关系:掩码决定了编辑范围。阶段②产生的二值掩码既传递给阶段③做可视化校验,又传递给阶段④约束扩散模型仅在遮罩区域采样,从而保证未遮挡部分保持时空一致性。
根据演讲者的演示,该工作流覆盖对象移除、对象替换、局部重绘和视频延展四种场景。编辑流程的生成速度与标准推理一致——前文所有优化(稀疏注意力、投影缓存等)均可叠加生效。
节点层的局限: ComfyUI 解决了"可视化操作"问题,但并未消除提示词调优和反复抽卡的人工成本。当任务目标从"编辑一个片段"扩展到"制作一支完整短片"时,人工环节的数量线性增长。
编排层:JiuwenSwarm 多 Agent 框架
PPT 第 23 页展示了 JiuwenSwarm Harness 的设计界面(开源地址:github.com/openJiuwen-ai/jiuwenswarm),其中包含三类 Agent 节点及其任务流转关系:
| Agent 角色 | 职责 | 输入 → 输出 |
|---|---|---|
| 主 Agent | 接收用户的一句话描述,拆解为创意简报与视频文稿 | 自然语言 → 结构化分镜脚本 |
| Sub-agent(角色与场景) | 根据分镜脚本调用图片生成模型,产出各段参考图 | 分镜脚本 → 参考图集 |
| Sub-agent(分镜生成) | 针对每段分镜调用 vLLM-Omni 视频模型服务,逐段生成视频 | 参考图 + 提示词 → 视频片段 |
| 合成节点 | 将多段视频按时间线拼接输出 | 视频片段列表 → 完整成片 |
主 Agent 的核心作用是将创意意图转化为可执行的工作流参数——它接入一个大语言模型自动完成文案撰写和分镜设计,并将每段分镜的描述分发给下游 Sub-agent。一个重要的工程细节是:JiuwenSwarm 可直接导入已有的 ComfyUI 工作流文件,无需从零搭建 Agent 管线。
演讲者展示了一个实际样例:用户输入一句话描述《桃花源记》的主题,系统自动完成分镜设计、素材生成与视频拼接,输出一支完整 MV。但演讲者也明确表示,JiuwenSwarm 目前处于前期初步阶段。演讲材料未给出端到端成片的耗时数据、Agent 决策的成功率或分镜质量的量化评估。
小结
两层封装形成递进关系:ComfyUI 节点将推理框架的底层能力包装为可拖拽、可组合的视觉模块,降低单次编辑操作的门槛;JiuwenSwarm 在此基础上引入多 Agent 协作,将"多次编辑 + 人工串联"压缩为一次自然语言交互。两者共同指向同一个工程目标——让优化不仅停留在吞吐数字上,而是切实转化为用户可感知的创作效率提升。
结论与已知局限
核心结论
-
工程优化是一场系统级的连锁博弈。 从画质(超分)到显存(分布式)到时长(续写)到速度(稀疏注意力、投影缓存)再到交付(数据搬运),每解决一个瓶颈就暴露下一个。任何单点的改进都无法独立发挥价值,必须在多个相互制约的指标间寻找全局平衡。
-
消除"木桶短板"往往比继续优化最快的算子更有效。 注意力内核提速 3.43 倍(测试条件:8 × SM120、FastH3 VSA、30 秒、1344×768、24 FPS)最终仅转化为 1.14 倍的端到端加速,而将格式转换从 CPU 前置到 GPU 这一轻量改动却直接把传输量压缩至 1/4。识别并消除全链路中的非计算瓶颈,通常带来最直接的收益。
-
分布式方案必须与模型架构的具体细节对齐。 Window-aligned SP 之所以将 SeedVR2 超分从 10 分钟压缩到 50 秒(8 × B300),正是因为它以窗口注意力结构为前提做了定制化设计——以完整窗口为最小分配单元,仅在窗口切换点执行 all-to-all 通信——而非套用通用的序列并行方案。
-
技术能力的最终价值取决于用户是否能触达。 ComfyUI 节点与 JiuwenSwarm Agent 框架将底层硬核优化封装为可操作的界面和可编排的服务,是从实验室指标走向实际业务场景的必要一步。
已知局限
-
性能数据高度依赖硬件与配置。 12 倍加速(8 × B300)和 13 秒生成 15 秒视频(8 × RTX PRO 6000)均为特定条件下的实测值。不同卡型、分辨率、采样步数或模型版本下结果可能显著不同,部署时需重新评估。
-
潜空间二次细化会系统性改变画面风格。 该路线虽然速度更快,但第二轮去噪引入的模型先验会改变色彩分布与细节质感。静态截图对比无法完全反映连续播放时的实际观感差异。
-
局部算子加速比在端到端场景中被大幅摊薄。 HTTP 通信、数据传输、调度等待等非计算环节在总耗时中占据可观份额。优化时应始终以完整请求延迟为基准度量,避免被内核级加速比误导。
-
自动化框架尚处早期。 JiuwenSwarm 多 Agent 编排目前为初步版本,演讲材料未给出端到端成片耗时、Agent 决策成功率或分镜质量的量化数据,实际应用效果有待验证。